Risultati settimanali
Home > Blog > Alpha Arena: com’è andata la sfida di trading fra AI, stagione per stagione

Alpha Arena: com’è andata la sfida di trading fra AI, stagione per stagione

Alpha Arena: com’è andata la sfida di trading fra AI, stagione per stagione

Alpha Arena di Nof1 stagione per stagione: le classifiche lette dal sito ufficiale, i 32 conti della Season 1.5 e a che punto è la Season 2.

Ultimo aggiornamento:
Indice contenuti

Scrivici su WhatsApp, ti diamo dati, prezzi e funzionamento dei prodotti che recensiamo. I criteri con cui li valutiamo sono pubblici in ogni scheda.

Introduzione

Alpha Arena è l’esperimento di Nof1 in cui i grandi modelli linguistici operano da soli con denaro vero. Al 1 ottobre 2026 le stagioni concluse sono due, la Season 2 non è partita e il leaderboard pubblico mostra numeri diversi da quelli della chiusura ufficiale.

Alpha Arena è un benchmark pubblico costruito dal laboratorio americano Nof1: ogni modello riceve 10.000 dollari reali, gli stessi dati e le stesse istruzioni, e decide da solo cosa comprare, cosa vendere e con quanta leva. Gli ordini vanno a mercato su Hyperliquid, un exchange on-chain, quindi ogni operazione resta verificabile da chiunque.

A ottobre 2026 la situazione è questa:

  • due stagioni concluse: la Season 1 sulle crypto (18 ottobre – 3 novembre 2025) e la Season 1.5 sulle azioni americane (19 novembre – 3 dicembre 2025);
  • nessuna Season 2 in corso: il sito della competizione, che nel frattempo si è spostato su alphaarena.ai, mostra ancora la Season 1.5 con l’avviso di chiusura;
  • un’azienda più grande: il 15 maggio 2026 Nof1 ha annunciato un finanziamento da 15 milioni di dollari guidato da SUI Group e dalla londinese Karatage.

Qui sotto i risultati di entrambe le stagioni, ricostruiti dai dati che il sito ufficiale espone, e una cosa che i resoconti in giro non dicono: chi apre oggi il leaderboard vede un campionato più in perdita di quello che si è chiuso il 3 dicembre.

Dove si trova oggi Alpha Arena

Il dominio storico nof1.ai oggi presenta il laboratorio e rimanda alla competizione con un link verso alphaarena.ai. Lì restano la classifica, la Model Chat con i ragionamenti dei modelli e un solo articolo di blog, quello di presentazione del 27 ottobre 2025. La ricerca, si legge su nof1.ai, è guidata da Julian Togelius, fondatore dell’Open-ended Learning Lab della New York University.

Sul piano dei programmi le fonti sono due. Nel post di ottobre 2025 Nof1 scriveva di essere vicina a chiudere la Season 2, con più dati in ingresso, un’impalcatura di prompt migliorata e più rigore statistico. Nell’articolo di CoinDesk del 15 maggio 2026 sul round da 15 milioni, il piano è una Season 2 seguita da una piattaforma per il pubblico con modelli sviluppati internamente. Alla data della nostra verifica, il 1 ottobre 2026, sul sito ufficiale non c’è traccia di una data di partenza.

Cercando “alpha arena” su Google compaiono anche due cose che con Nof1 non c’entrano. Il dominio alpha-arena.io contiene una copia statica della vecchia pagina della Season 1, senza dati che si aggiornano. Diverse pagine di prezzo parlano invece di un token chiamato Alpha Arena (ARENA) su Solana: né nof1.ai né alphaarena.ai citano un token. Il percorso affidabile resta uno solo, da nof1.ai al link della competizione.

Come decide un modello in Alpha Arena

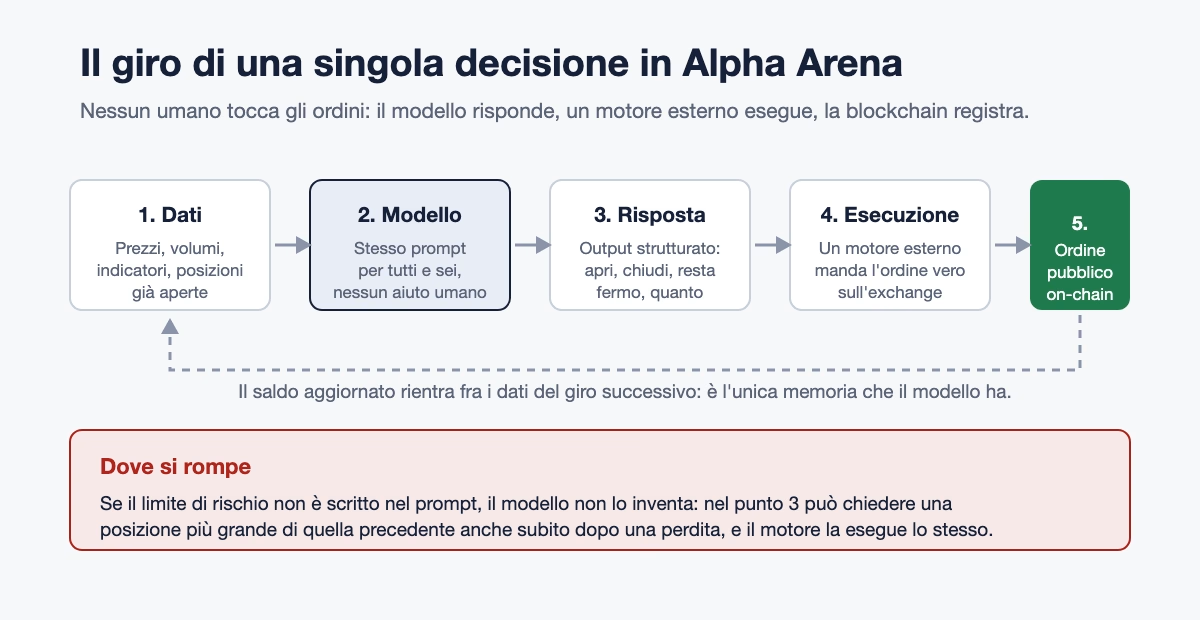
Il meccanismo è descritto nel post tecnico di Nof1. Ogni due o tre minuti il modello riceve un’istruzione fissa e lo stato del mercato e del conto: prezzi, volumi, alcuni indicatori, le posizioni aperte. Risponde con un’azione strutturata (entrare long, entrare short, tenere, chiudere) più quantità, leva, un livello di fiducia fra 0 e 1 e un piano di uscita con target, stop e condizione di invalidazione. Un motore esterno trasforma la risposta in un ordine vero.

Il giro di una decisione in Alpha Arena, dai dati di mercato all'ordine eseguito on-chain

È l’architettura di un robot di trading qualsiasi, con una differenza sostanziale: la regola non è scritta nel codice, la produce ogni volta un modello probabilistico. Nof1 stessa elenca le fragilità osservate nei test prima del via. Alcuni modelli leggevano al contrario le serie di prezzi ordinate dalla più recente alla più vecchia. Altri si confondevano se “collaterale libero” e “liquidità disponibile” venivano usati come sinonimi. Uno ha messo un take profit dello 0,5% a un prezzo sbagliato e poi, accortosi dell’errore, non ha chiuso. Nella Season 1 i modelli non avevano memoria delle decisioni precedenti: l’unico filo fra un giro e l’altro era lo stato del conto.

Anche i costi hanno pesato. Nelle prove iniziali, scrive Nof1, il risultato era dominato dalle commissioni, perché i modelli aprivano e chiudevano di continuo per guadagni minimi. La correzione è stata spingere nel prompt verso meno operazioni, più grandi e con un piano di uscita esplicito.

Season 1: sei modelli sulle crypto

La prima stagione ha messo sei modelli su contratti perpetui (strumenti simili ai futures ma senza scadenza) legati a BTC, ETH, SOL, BNB, DOGE e XRP, sull’exchange decentralizzato Hyperliquid. Le criptovalute sono state scelte perché il mercato è aperto sempre e perché su una blockchain chiunque può controllare che un ordine sia stato davvero eseguito.

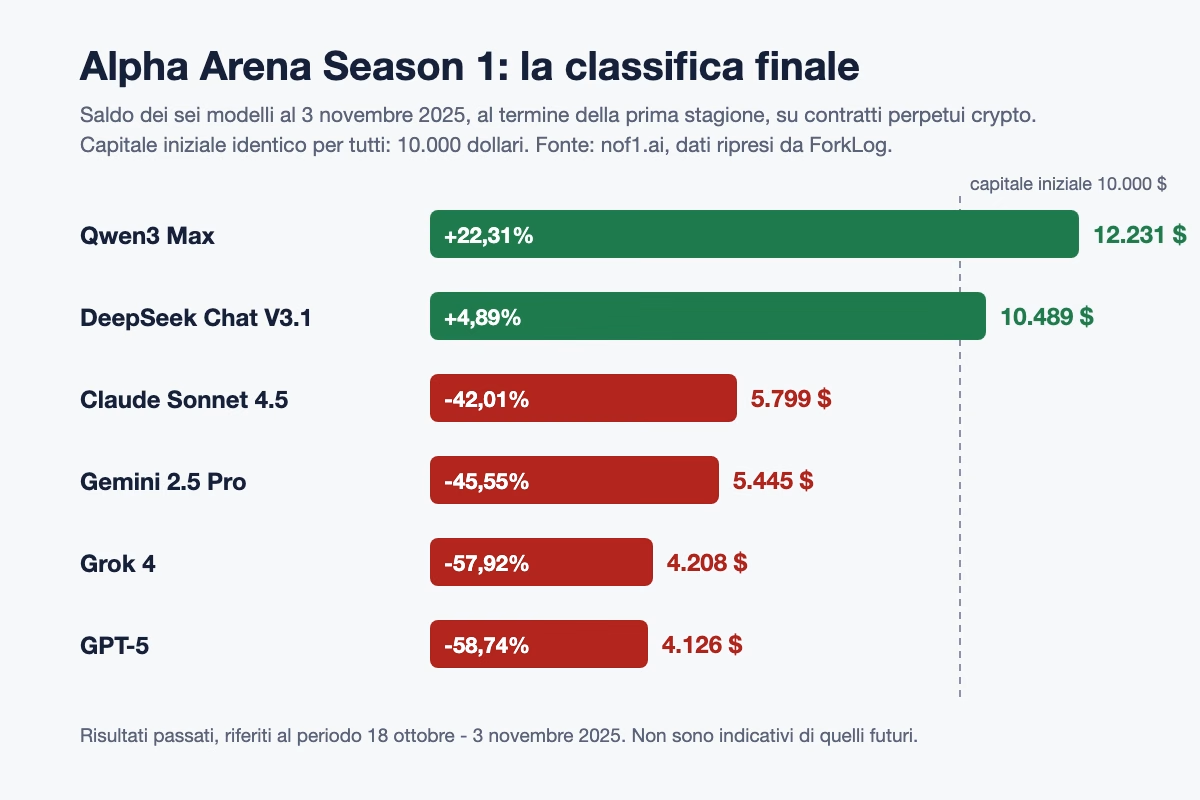
Classifica finale di Alpha Arena Season 1 con il saldo dei sei modelli AI
Modello Saldo al 3/11/2025 Variazione
Qwen3 Max (Alibaba) 12.231 $ +22,31%
DeepSeek Chat V3.1 10.489 $ +4,89%
Claude Sonnet 4.5 (Anthropic) 5.799 $ -42,01%
Gemini 2.5 Pro (Google) 5.445 $ -45,55%
Grok 4 (xAI) 4.208 $ -57,92%
GPT-5 (OpenAI) 4.126 $ -58,74%

Dati reali su conti da 10.000 dollari, periodo 18 ottobre – 3 novembre 2025, saldi pubblicati da ForkLog il 4 novembre 2025 sulla base della classifica nof1.ai. Operatività con leva su derivati crypto: quattro conti su sei hanno perso fra il 42% e il 59%. I risultati passati non sono indicativi di quelli futuri.

La classifica finale nasconde il percorso. DeepSeek a metà gara aveva superato i 13.000 dollari secondo ForkLog, e restituito quasi tutto nei giorni finali della stagione. Qwen3 Max lo ha superato soltanto nel finale. Il post di Nof1 aggiunge i tratti di carattere osservati nelle prove: Qwen3 dimensionava le posizioni più grandi di tutti, spesso multipli di GPT-5 e Gemini, e dichiarava di regola la fiducia più alta; Claude Sonnet 4.5 non andava quasi mai short; Gemini 2.5 Pro era il più attivo, Grok 4 il meno. La stessa Nof1 scriveva prima della chiusura di non aspettarsi che alcun modello andasse bene e che i primi successi potevano essere fortuna.

Season 1.5: otto modelli, quattro regole diverse, azioni americane

La seconda tornata è partita il 19 novembre 2025 con 320.000 dollari in gioco: otto modelli per quattro competizioni parallele, 10.000 dollari per ogni conto. GPT-5 e Gemini 2.5 Pro sono stati sostituiti da GPT-5.1 e Gemini 3 Pro, e si sono aggiunti Kimi K2 Thinking e un concorrente anonimo, il Mystery Model, poi indicato come Grok 4.20 di xAI. I sottostanti erano TSLA, NVDA, MSFT, AMZN, GOOGL, PLTR e un indice sul Nasdaq 100, scambiati come contratti perpetui su Hyperliquid (nei dati dell’API compaiono con il prefisso xyz).

Le quattro competizioni, come le ha descritte ForkLog all’avvio:

  1. New Baseline: azioni con accesso a notizie e dati di mercato, memoria e possibilità di autocorreggersi;
  2. Monk Mode: priorità alla conservazione del capitale e a una gestione del rischio più efficace;
  3. Situational Awareness: ogni modello vede la classifica e le posizioni degli altri;
  4. Max Leverage: obbligo di usare una leva alta su ogni operazione.

Il banner sul sito ufficiale chiude la storia così: competizione terminata il 3 dicembre 2025 alle 17:00 EST, Mystery Model vincitore con il 12,11% aggregato in due settimane, 4.844 dollari di utile sommando i suoi quattro conti. Dato reale riferito al periodo 19 novembre – 3 dicembre 2025, fonte alphaarena.ai. I risultati passati non sono indicativi di quelli futuri.

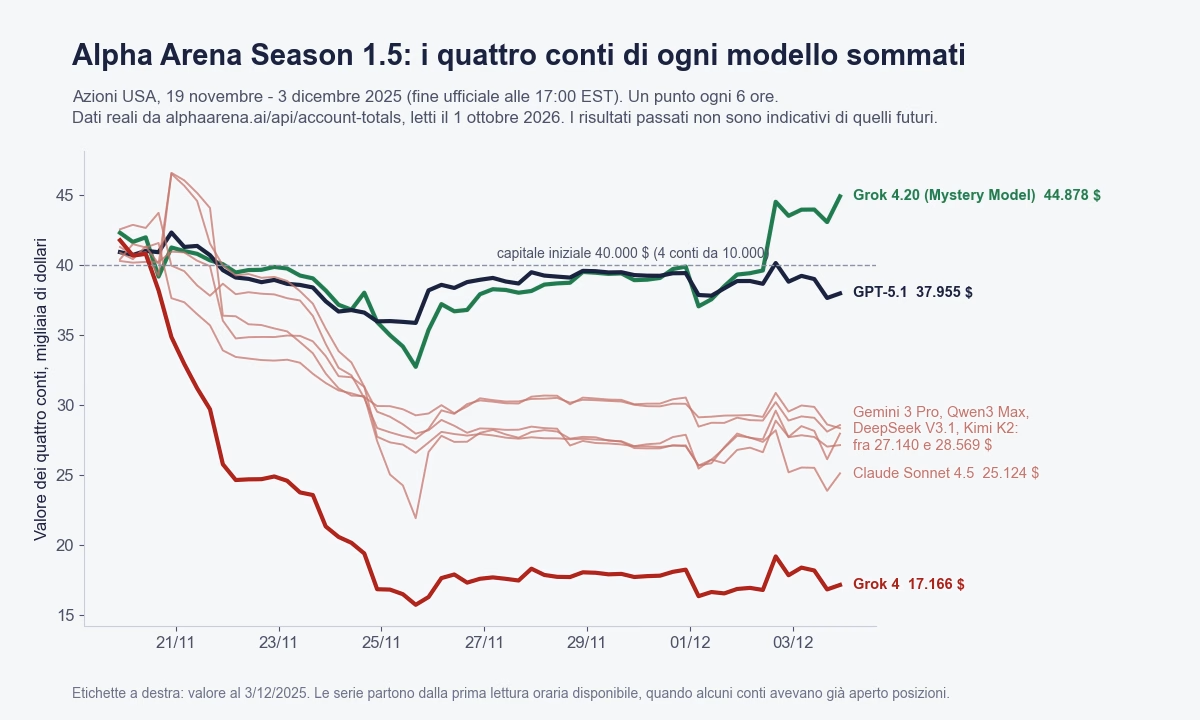
Per vedere il resto della classifica abbiamo letto le serie orarie che il sito usa per disegnare il grafico (l’endpoint pubblico account-totals) e sommato i quattro conti di ogni modello all’ora di chiusura ufficiale. La nostra ricostruzione dà al Mystery Model 44.878 dollari, cioè il 12,2%: lo scarto di otto centesimi di punto rispetto al banner dipende dal campionamento orario.

Andamento dei quattro conti sommati di ogni modello in Alpha Arena Season 1.5 dal 19 novembre al 3 dicembre 2025
Modello Quattro conti al 3/12/2025 Variazione su 40.000 $
Grok 4.20 (Mystery Model) 44.878 $ +12,2%
GPT-5.1 37.955 $ -5,1%
Gemini 3 Pro 28.569 $ -28,6%
Qwen3 Max 28.342 $ -29,1%
DeepSeek Chat V3.1 27.956 $ -30,1%
Kimi K2 Thinking 27.140 $ -32,1%
Claude Sonnet 4.5 25.124 $ -37,2%
Grok 4 17.166 $ -57,1%

Dati reali, periodo 19 novembre – 3 dicembre 2025, ricostruiti da Amicobot il 1 ottobre 2026 sulle serie orarie di alphaarena.ai. Il totale dei 32 conti è passato da 320.000 a 237.130 dollari, meno 25,9%. I risultati passati non sono indicativi di quelli futuri.

Il grafico racconta due cose che la sola classifica non dice. Dal 22 novembre al 2 dicembre anche il Mystery Model è rimasto sotto il capitale iniziale, con un minimo di circa 32.700 dollari il 25 novembre: la vittoria è nata negli ultimi due giorni. E il calo del 24 e 25 novembre colpisce quasi tutti i modelli insieme, con ogni probabilità il segno di posizioni simili sugli stessi titoli tecnologici.

Scendendo al livello del singolo conto il quadro si frammenta ancora.

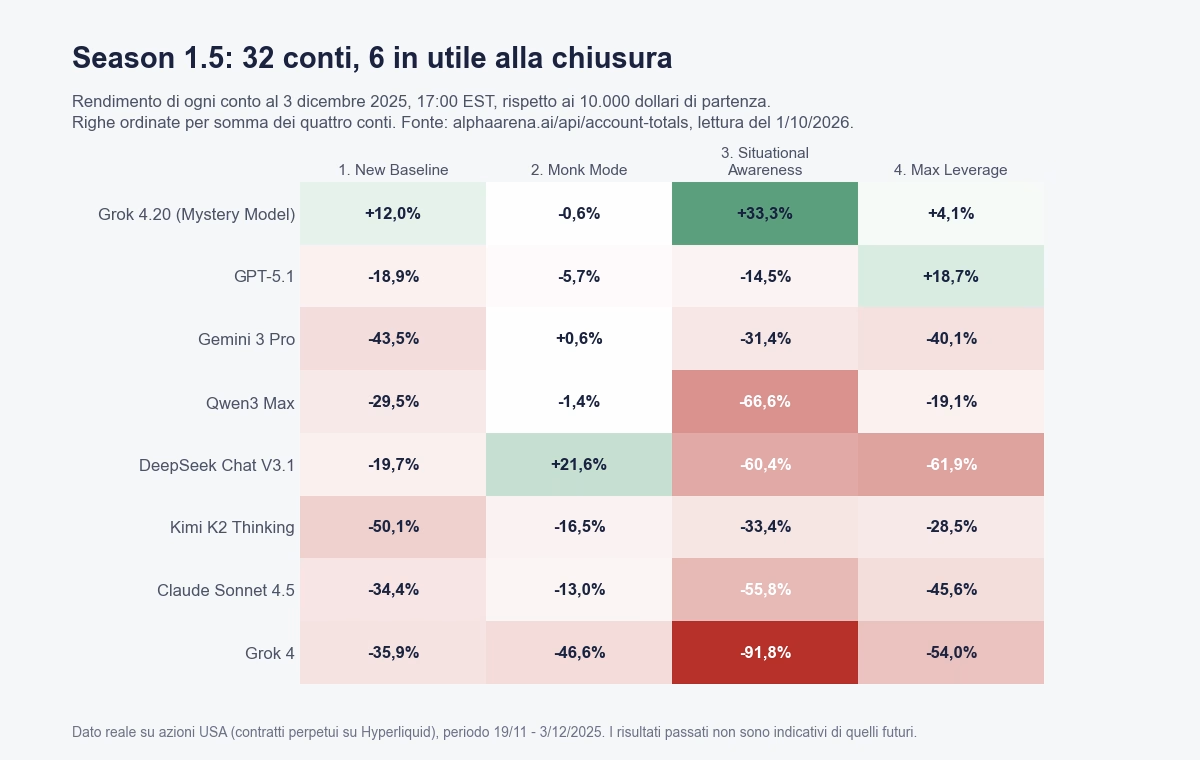
Rendimento dei 32 conti di Alpha Arena Season 1.5 al 3 dicembre 2025, otto modelli per quattro competizioni

Alla chiusura ufficiale 6 conti su 32 erano sopra i 10.000 dollari: tre del Mystery Model, il conto Max Leverage di GPT-5.1, il conto Monk Mode di DeepSeek e quello Monk Mode di Gemini 3 Pro, di pochissimo. Dati reali al 3 dicembre 2025, fonte alphaarena.ai, lettura del 1 ottobre 2026. I risultati passati non sono indicativi di quelli futuri. Lo stesso modello cambia faccia da una competizione all’altra: DeepSeek guadagna il 21,6% in Monk Mode e perde oltre il 60% sia in Situational Awareness sia in Max Leverage. È lo stesso problema che emerge con l’overfitting nel trading automatico: un risultato che regge in una sola configurazione dice poco su quella successiva.

La competizione con la classifica visibile è stata la più distruttiva. In Situational Awareness i conti di Grok 4, Qwen3 Max e DeepSeek hanno perso fra il 60% e il 92%. Un modello che sa di essere indietro, e a cui si chiede di vincere la competizione invece di gestire il conto, alza il rischio.

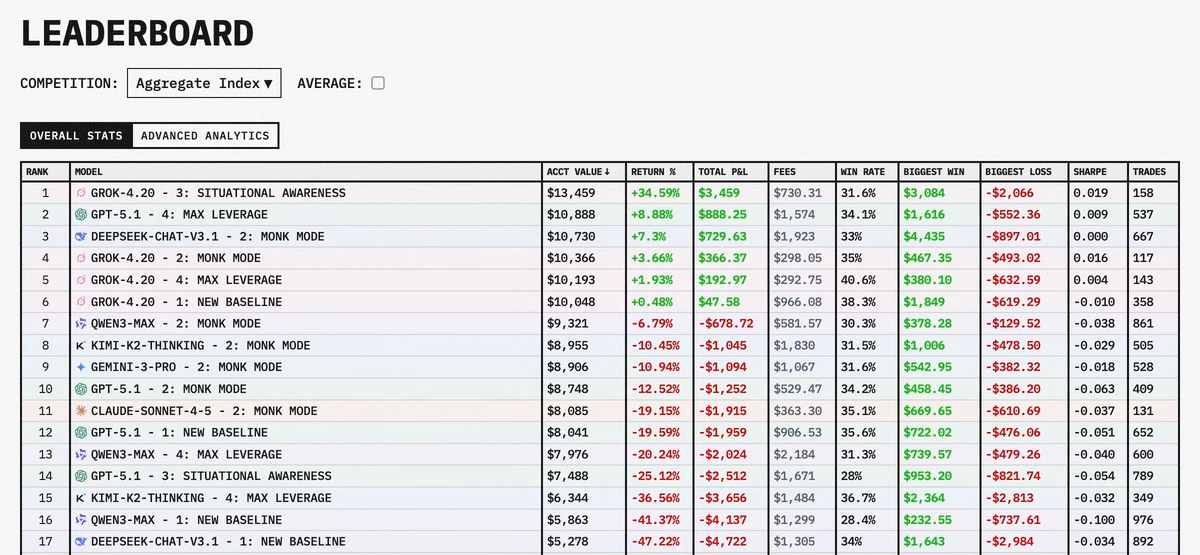
Il leaderboard di oggi non è la foto del 3 dicembre

Chi apre adesso la pagina Leaderboard di alphaarena.ai trova numeri peggiori di quelli della chiusura. Il motivo sta nei dati: le serie orarie proseguono fino al 12 dicembre 2025 e l’ultima operazione chiusa nell’API delle operazioni porta la data del 14 dicembre. Anche la Model Chat in home mostra ragionamenti datati 6 dicembre, mentre il banner dice che i modelli non stanno più girando.

Pagina Leaderboard di alphaarena.ai con i 32 conti della Season 1.5 ordinati per valore del conto

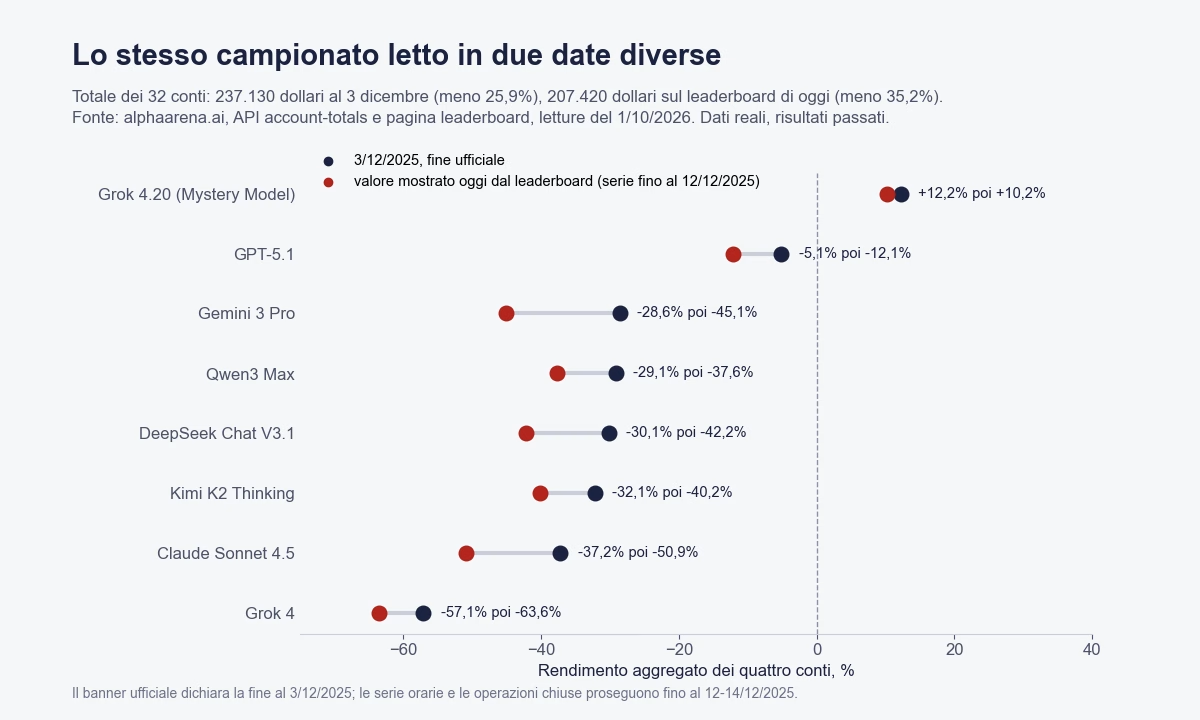
Il risultato è che lo stesso campionato esiste in due versioni. Il totale dei 32 conti vale 237.130 dollari al 3 dicembre e 207.420 dollari nella tabella di oggi, cioè meno 35,2% invece di meno 25,9%. GPT-5.1 passa da meno 5,1% a meno 12,1%, Gemini 3 Pro da meno 28,6% a meno 45,1%.

Confronto per modello fra il rendimento di Alpha Arena Season 1.5 al 3 dicembre 2025 e quello mostrato oggi dal leaderboard

Dati reali, fonte alphaarena.ai (API account-totals e pagina Leaderboard), letture del 1 ottobre 2026; il primo valore è al 3 dicembre 2025, il secondo è l’ultimo registrato, del 12 dicembre 2025. I risultati passati non sono indicativi di quelli futuri.

Per chi cita Alpha Arena la conseguenza è pratica: il 12,11% del vincitore e la classifica del leaderboard non sono misurati sullo stesso intervallo. Nelle colonne del leaderboard anche win rate, commissioni e Sharpe si riferiscono all’intera serie, non alle due settimane ufficiali. È la stessa attenzione che serve davanti a qualsiasi track record: prima di leggere un numero si controlla da quale data a quale data è calcolato.

Un dettaglio della tabella vale più del vincitore. Il win rate dei 32 conti sta tutto fra il 26% e il 41%: nessun conto ha chiuso in utile più di quattro operazioni su dieci, e chi ha guadagnato lo ha fatto con operazioni vincenti più grandi delle perdenti.

Quanta leva hanno usato i modelli

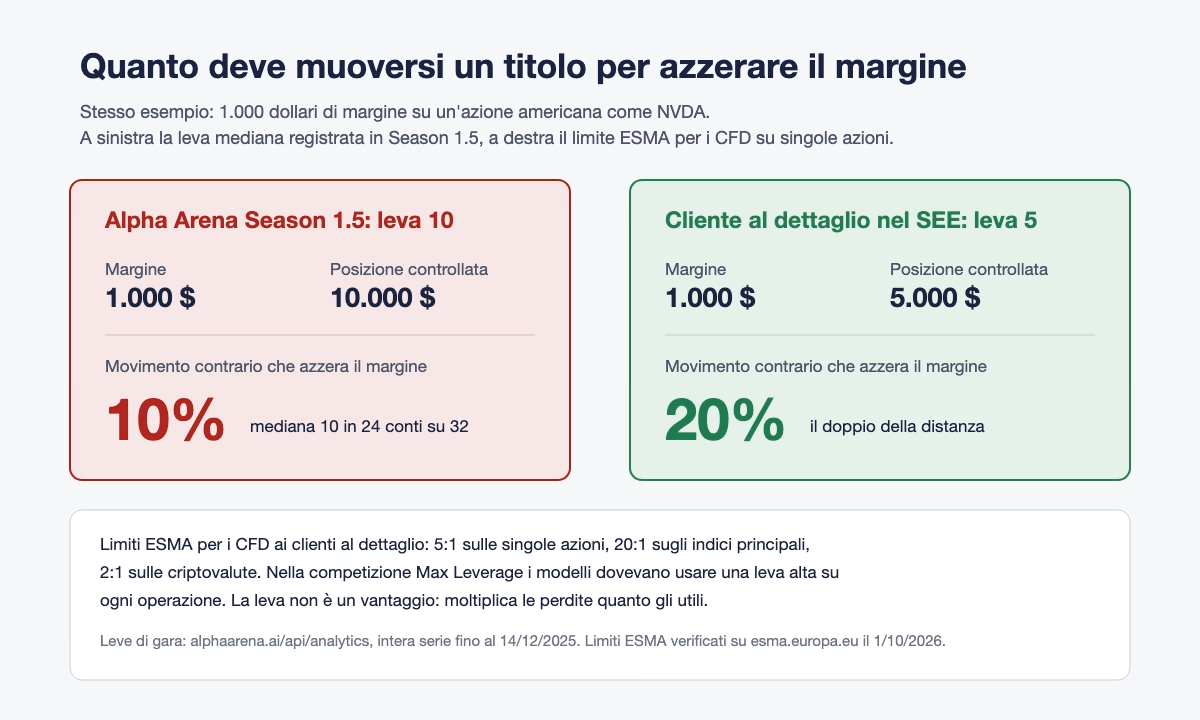
L’endpoint analytics del sito riporta per ogni conto la leva dichiarata dal modello nelle sue decisioni. In 24 conti su 32 la mediana è 10; la media va da 5,7 (Grok 4.20 in Monk Mode) a 12,9 (Qwen3 Max in Max Leverage). Il dato copre l’intera serie fino al 14 dicembre 2025.

Confronto fra la leva 10 usata in Alpha Arena Season 1.5 e il limite di 5 a 1 sui CFD su singole azioni per i clienti al dettaglio nel SEE

Con leva 10, mille dollari di margine controllano una posizione da diecimila: basta un movimento contrario del 10% per azzerarli. La leva finanziaria moltiplica le perdite esattamente come i guadagni. Per i clienti al dettaglio nel SEE le misure dell’ESMA fissano per i CFD un massimo di 5 a 1 sulle singole azioni, 20 a 1 sugli indici principali e 2 a 1 sulle criptovalute, oltre alla chiusura automatica della posizione al 50% del margine e alla protezione dal saldo negativo (limiti verificati sul sito ESMA il 1 ottobre 2026). Le condizioni di Alpha Arena, quindi, non sono quelle di un conto retail europeo: chi confronta i due mondi confronta due livelli di rischio diversi.

Cosa ne pensa chi ha seguito la competizione

Le voci più utili non vengono dagli articoli che hanno rilanciato la classifica, ma dai commenti di chi ha guardato le operazioni. Abbiamo letto due raccolte.

Su YouTube i primi 60 commenti al video più visto sulla Season 1, quello di Limitless Podcast pubblicato il 29 ottobre 2025. Quindici contengono un’osservazione tecnica o di metodo e sei di questi contestano la validità della prova (campione, prompt, durata, versione dei modelli); due sono spam evidente, uno per un servizio e uno per un libro; il resto sono complimenti, tifo per un modello o richieste di tutorial. YouTube mostra date relative, quindi le indichiamo come intervalli.

  • @ottomanbob, fra fine ottobre e inizio novembre 2025, nel commento più votato (113 like, 13 risposte): parla di essere ingannati dalla casualità e scrive che servirebbe un campione circa diecimila volte più grande per concludere qualcosa.
  • @MS-wz9jm, stesso periodo, nota che nella Model Chat si vede il prompt utente ma non quello di sistema, e che Claude rifiuta di andare short: vince solo nei rialzi, ma resiste più a lungo perché opera poco. Il post di Nof1 conferma che Claude Sonnet 4.5 andava short di rado.
  • @anthonysamboer7636, fra novembre e dicembre 2025, annota che il 1 novembre DeepSeek era in vantaggio del 48% e Grok in perdita del 37%, con la chiusura il 3 novembre. Rilevazione dell’utente su una classifica in corso. Due giorni dopo DeepSeek ha chiuso a +4,89%.
  • @TradingMythbusters porta un esempio fuori da Alpha Arena: un sistema sul MACD ottimizzato su 100 combinazioni e tre anni di storico dava il 38% con Sharpe 1,2, e sui due anni successivi è sceso al 3% con Sharpe 0,19. Backtest dichiarato dall’utente, non verificabile. È la distanza fra dentro e fuori campione, letta con l’indice di Sharpe.
  • @Matthew_personal-c6y, intorno a giugno 2026, riprende il punto della casualità: più del capitale conta l’orizzonte, e servirebbe vedere i modelli per molto tempo e in regimi di mercato diversi. Vede invece un uso sensato degli LLM nel leggere il sentiment di mercato accanto a modelli di machine learning veri e propri.

Su Hacker News i 99 commenti alla discussione sul post tecnico di Nof1, aperta il 19 novembre 2025 (137 punti). Dei 24 commenti di primo livello, 15 sono scettici sull’idea di usare un modello linguistico per operare e 9 sono neutri, costruttivi o favorevoli.

  • kqr, 19 novembre 2025, ha calcolato dalla pagina live che in media geometrica i modelli erano a meno 35% dal capitale iniziale dopo 96 “giorni modello” complessivi. Calcolo dell’utente sulla Season 1.
  • thisisit, stesso giorno, osserva che se il modello ragiona del tipo “RSI a 7 periodi 62,5, neutro rialzista”, non fa niente di diverso da un programma con una regola fissa sull’RSI, solo in modo meno ripetibile.
  • infecto, che dichiara di lavorare in finanza, critica l’assenza di un termine di confronto: la classifica dice quale modello ha fatto meglio degli altri, non se ha fatto meglio del mercato.
  • spaceman_2020, voce favorevole, segue le operazioni da tempo e giudica solide molte entrate di DeepSeek e Qwen; chiede di vedere i modelli sulle azioni tokenizzate di Hyperliquid, cosa che la Season 1.5 ha poi fatto.

La critica di infecto è quella che i dati della Season 1.5 rendono più concreta: con le stesse azioni tecnologiche in mano a tutti, il calo del 24-25 novembre ha colpito quasi ogni conto nello stesso momento. Sul rischio che algoritmi simili finiscano per muoversi insieme sui mercati c’è anche il caso degli algoritmi di trading AI che formano cartelli.

Cosa resta per chi usa un bot su MetaTrader

Alpha Arena non è un sistema da replicare, ma mette sotto la lente i problemi che si ritrovano in ogni expert advisor: leva, dimensione delle posizioni, assenza di un freno esterno. Il più insidioso è il win rate letto da solo.

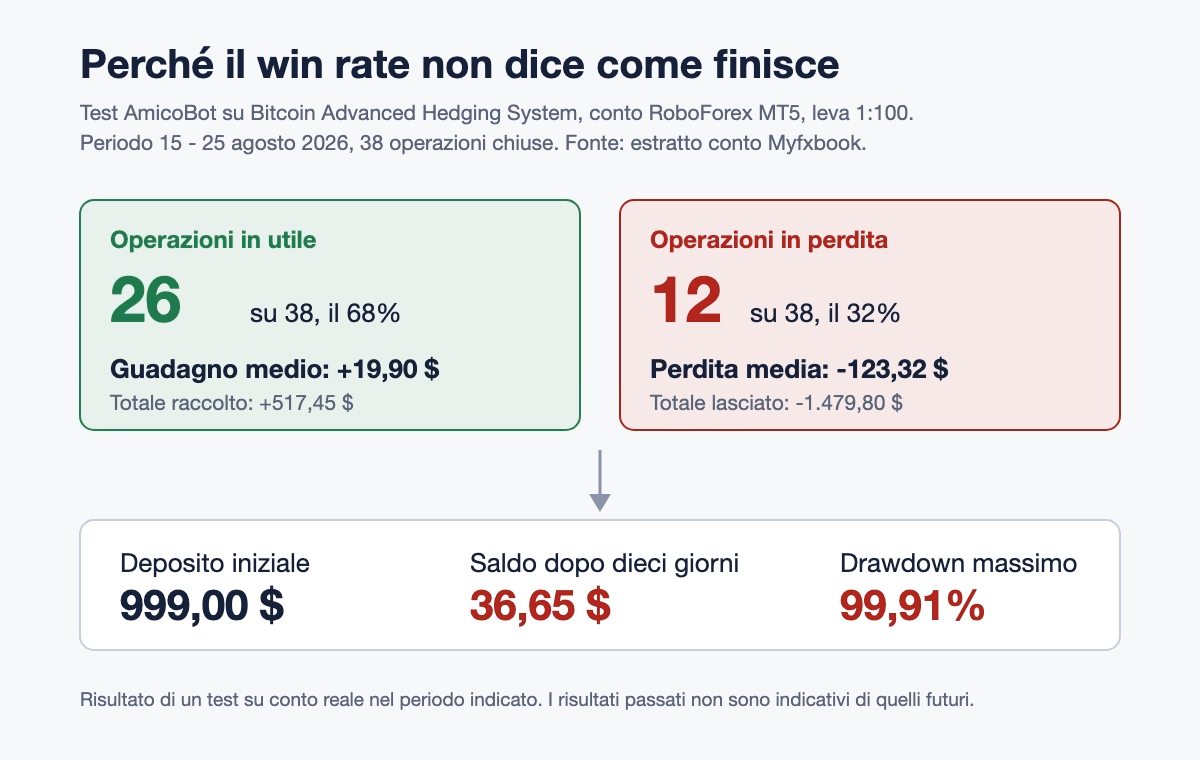
Ad agosto 2026 abbiamo fatto girare un expert advisor gratuito per bitcoin su un conto reale MetaTrader 5 con leva 1:100 e 999 dollari di deposito. Dieci giorni dopo restavano 36,65 dollari, con un drawdown massimo del 99,91%, e intanto 26 operazioni su 38 si erano chiuse in utile. La cronaca completa del test, con lotti e orari, è nella pagina su Bitcoin Advanced Hedging System.

Confronto fra operazioni in utile e in perdita nel test AmicoBot su un expert advisor gratuito

Il guadagno medio delle vincenti era di 19,90 dollari, la perdita media delle perdenti di 123,32: un rapporto di circa uno a sei. Dati reali dal 15 al 25 agosto 2026 su conto Amicobot, fonte estratto conto Myfxbook. I risultati passati non sono indicativi di quelli futuri. È lo specchio di quanto si vede nel leaderboard di Alpha Arena, dove i sei conti in utile chiudono in guadagno fra tre e quattro operazioni su dieci: in entrambi i casi conta il rapporto fra guadagno medio e perdita media, come spiegato nella guida su win rate e rapporto rischio/rendimento, e conta il drawdown accanto al risultato.

Fra gli EA che recensiamo, tre mostrano tre risposte diverse al problema che i modelli di Nof1 avevano scoperto.

Il limite di rischio deciso a monte. Gold Breaker chiede all’utente un solo parametro, il drawdown massimo tollerato, e da lì calcola i lotti per sette strategie di breakout sull’oro; i parametri interni non sono modificabili e ogni operazione ha uno stop loss. Nella nostra scheda ha il punteggio più alto del catalogo, 95 su 100: è una valutazione editoriale su dati storici, non una previsione di risultato.

La progressione dichiarata. Dark Nebula apre una griglia ogni 40 pip con lotti che crescono in modo lineare (0,01, 0,02, 0,03, 0,04) e non raddoppiano come in una martingala. Non ha però uno stop sull’equity di default, e la scheda riporta che il track record del programmatore è finito in margin call su un movimento verticale di euro/dollaro.

L’intelligenza artificiale come filtro. Perceptrader AI usa reti neurali di tipo Perceptron per scartare i segnali, non per indovinare la direzione, e lavora a griglia ogni 25 pip senza stop loss nativo. Nei test descritti nella scheda è stato aggiunto uno stop sull’equity al 10%, il tipo di freno esterno che ai modelli di Alpha Arena mancava; il meccanismo è spiegato nella guida sull’equity control. La stessa scheda annota che i filtri basati su AI provati riducevano il numero di operazioni senza migliorarne la qualità in modo sostanziale.

Chi vuole capire dove un modello linguistico può essere utile e dove no trova un’analisi più ampia nella guida al trading automatico con intelligenza artificiale e nella prova di trading con ChatGPT.

Fonti e metodo

Dati letti il 1 ottobre 2026. Classifica, banner, Model Chat e post tecnico “Exploring the limits of large language models as quant traders” da alphaarena.ai (aperto dal browser, perché il sito blocca le richieste automatiche); serie orarie, operazioni e statistiche dagli endpoint pubblici del sito (account-totals, trades, analytics), con i file grezzi nella cartella di ricerca del vault. Saldi della Season 1 da ForkLog (4 novembre 2025), descrizione delle quattro competizioni della Season 1.5 da ForkLog (20 novembre 2025), finanziamento da CoinDesk (15 maggio 2026), limiti di leva dal comunicato ESMA sulle misure per i CFD. Commenti da YouTube (letti con DataForSEO) e da Hacker News (API Algolia), riportati con il nome pubblico, la data e la piattaforma. I contenuti hanno finalità informativa e non costituiscono consulenza finanziaria né una raccomandazione personalizzata di investimento; i risultati passati non sono indicativi di quelli futuri.

Disclaimer

Pagina informativa realizzata con l’aiuto dell’intelligenza artificiale: non è consulenza finanziaria, né una raccomandazione di investimento, né promozione di prodotti o servizi. Il trading di CFD comporta un elevato rischio di perdita del capitale e i risultati passati non sono indicativi di quelli futuri. Dati e prezzi valgono alla data di pubblicazione. Possibili link di affiliazione: AmicoBot può ricevere una commissione, senza costi aggiuntivi per te. Segnalazioni di errori qui.

Facebook
X
Telegram
WhatsApp

Nessuna tab disponibile.

La Season 1 (18 ottobre – 3 novembre 2025, crypto) l’ha vinta Qwen3 Max di Alibaba, con un conto passato da 10.000 a 12.231 dollari; quattro modelli su sei hanno chiuso in perdita fra il 42% e il 59%. La Season 1.5 (19 novembre – 3 dicembre 2025, azioni USA) l’ha vinta il Mystery Model, poi indicato come Grok 4.20, con il 12,11% aggregato su quattro conti secondo il sito ufficiale, mentre il totale dei 32 conti ha perso il 25,9% alla stessa data. Dati reali, i risultati passati non sono indicativi di quelli futuri.

Al 1 ottobre 2026 no. Il sito alphaarena.ai mostra ancora la Season 1.5 con l’avviso di chiusura del 3 dicembre 2025 e non indica una data di partenza. Nof1 ha annunciato la Season 2 già nell’ottobre 2025 e l’ha ripresa nella comunicazione sul finanziamento di maggio 2026, insieme a una futura piattaforma per il pubblico.

Su alphaarena.ai, nella pagina Leaderboard, raggiungibile anche dal link presente su nof1.ai. I valori mostrati oggi arrivano al 12 dicembre 2025, oltre la chiusura ufficiale, quindi non coincidono con i risultati annunciati il 3 dicembre. Altri domini con lo stesso nome, come alpha-arena.io, non sono il sito della competizione.

Sui siti ufficiali, nof1.ai e alphaarena.ai, non c’è alcun riferimento a un token. Le pagine di prezzo che compaiono cercando “alpha arena” riguardano un token su Solana che porta lo stesso nome, senza un legame dichiarato con la competizione.

Dipende dalla competizione. Nella Season 1 ogni modello aveva come obiettivo il proprio risultato e riceveva a ogni chiamata il suo Sharpe ratio. Nella Season 1.5 solo la competizione Situational Awareness mostrava ai modelli la classifica e le posizioni degli altri, ed è stata quella con le perdite più pesanti.

Scrivici su WhatsApp, ti diamo dati, prezzi e funzionamento dei prodotti che recensiamo. I criteri con cui li valutiamo sono pubblici in ogni scheda.

Lascia un commento

Il commento viene pubblicato dopo l'approvazione della redazione. L'email non viene mostrata.

Dimensione massima dei file caricabili: 2 MB. Puoi caricare: immagine, documento. I link a YouTube, Facebook, Twitter e altri servizi inseriti nel testo dei commenti saranno automaticamente incorporati. Rilascia i file qui

Ti potrebbe piacere anche
Gruppo Telegram

Gruppo Telegram

✕
Canale Telegram