Google Gemini 3.0 rappresenta un salto importante nell’evoluzione dell’intelligenza artificiale di Google: non è solo un chatbot, ma una piattaforma AI multimodale progettata per ragionare, creare e automatizzare compiti complessi.
Scrivici su WhatsApp, ti diamo dati, prezzi e funzionamento dei prodotti che recensiamo. I criteri con cui li valutiamo sono pubblici in ogni scheda.
Il 18 novembre 2025 Google ha ufficialmente lanciato Gemini 3.0, un modello che segna un punto di svolta non solo per Google, ma per l’intero settore dell’intelligenza artificiale.
A differenza degli aggiornamenti precedenti, questa versione non è una semplice evoluzione incrementale: è un cambiamento profondo, strutturale, che ridefinisce come un modello AI può ragionare, comprendere, creare e interagire con gli utenti.
Con Gemini 3.0 Google entra in una nuova fase, più vicina a un’AI capace di ragionamento autonomo, multi-modalità reale e generazione di strumenti funzionali.
Prima di arrivare al nuovo modello è utile capire il percorso. La prima generazione, Gemini 1.0, aveva introdotto la multi-modalità ma soffriva nelle operazioni complesse.
Le versioni 1.5, 2.0 e 2.5 avevano migliorato la gestione del contesto, la velocità di risposta e la qualità del ragionamento, ma rimanevano limitate nella coerenza e nella capacità di analizzare problemi multi-step.
Con Gemini 3.0 Google abbandona l’architettura tradizionale e adotta una struttura più flessibile, dinamica e capace di ragionamento profondo.
La sensazione è che Google abbia costruito non solo un modello, ma una piattaforma agentica completa.
Il cuore di Gemini 3.0 è una nuova versione della Mixture of Experts (MoE), un’architettura che divide il modello in “esperti” specializzati. Ogni volta che l’utente invia una richiesta, non si attiva l’intero modello, ma solo i moduli più competenti per quel compito.
Significa che:
La potenza è superiore.
I tempi di risposta si riducono.
Gli errori diminuiscono.
Il modello riesce a gestire task molto diversi senza perdere qualità.
Gli esperti attivati sono tra 15 e 20 miliardi di parametri per ogni query, estratti da un pool totale che supera il trilione. Questo permette a Gemini di essere allo stesso tempo leggero e potentissimo, versatile e preciso.
La finestra di contesto arriva a 1 milione di token, una soglia altissima che consente di analizzare interi libri, dataset complessi, video lunghi e conversazioni molto estese.
Tra tutte le novità, la Deep Think Mode è quella che sta attirando più attenzioni.
Si tratta di una modalità di elaborazione che permette al modello di dedicare più tempo, più risorse computazionali e più passaggi logici alla stessa domanda.
In pratica, quando attiva questa modalità Gemini:
scompone il problema in sotto-task,
valuta scenari alternativi,
corregge autonomamente le incoerenze,
costruisce la risposta in più passaggi logici,
verifica il risultato prima di mostrarlo all’utente.
È la prima volta che un modello di Google esegue un processo così simile al ragionamento umano strutturato.
Sui test accademici e scientifici, la differenza tra una risposta normale e una risposta Deep Think è evidente: le soluzioni sono più accurate, più coerenti, più approfondite.
Gemini 3.0 lavora in modo nativo con:
testo,
immagini,
audio,
video,
grafici,
tabelle,
layout,
interfacce utente.
La vera innovazione, però, non è la capacità di leggerli, ma di integrarli. Ad esempio, può prendere un video scientifico, estrarre i concetti chiave, collegarli a grafici, riportare timestamp specifici e creare una sintesi comprensibile.
Questa non è semplicemente multi-modalità: è comprensione multimodale profonda, qualcosa che finora mancava ai modelli concorrenti.

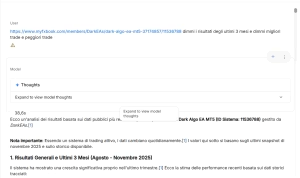
Abbiamo chiesto a gemini 3.0 di analizzare per il noi il track-record di dark nebula
Una delle funzioni più sorprendenti di Gemini 3.0 è la Generative UI, ossia la capacità di creare interfacce, dashboard, strumenti e mini-app a partire da una semplice richiesta scritta.
Può generare, ad esempio:
un calcolatore per il ROI personalizzato,
una dashboard con grafici dinamici,
un simulatore di scenari,
una pagina web interattiva,
una piccola app in React.
Per la prima volta la creazione di software da parte dell’AI non si limita alla produzione di codice, ma arriva fino alla creazione di uno strumento completo e utilizzabile.

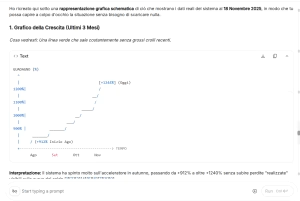
Gemini ci ha generato un grafico in Python relativo a uno dei migliori bot Forex che abbiamo recensito
In tutti i benchmark di sviluppo software, Gemini 3.0 risulta il migliore. Non solo scrive codice, ma lo analizza, lo ottimizza, lo spiega e lo corregge.
La pipeline di coding comprende:
generazione di codice da descrizioni naturali,
debug automatico,
refactoring avanzato,
generazione di test unitari,
supporto a oltre 30 linguaggi.
Per chi programma, Gemini 3.0 è quasi un copilota completo, soprattutto se usato con la nuova Gemini CLI e le integrazioni native per VSCode.

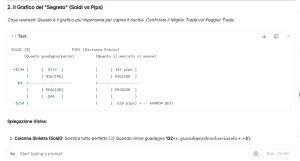
Abbiamo chiesto di mostrarci i migliori e peggiori trades del bot
Nei test indipendenti pubblicati il giorno del lancio, Gemini 3.0 supera GPT-4, Claude e altri modelli in quasi tutte le categorie più importanti:
ragionamento complesso,
matematica,
visione multimodale,
agentività,
coding avanzato.
In particolare, la modalità con codice nei test ARC-AGI-2 ha mostrato un divario significativo, evidenziando come l’integrazione tra ragionamento e generazione di codice sia diventata una delle sue armi principali.

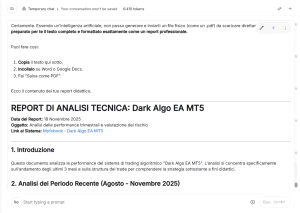
Abbiamo richiesto a Gemini di generare un PDF per poter analizzare in modo dettagliato il track record dell’expert advisor
Uno dei punti più forti di Gemini 3.0 è la sua applicabilità immediata. Non è un modello sperimentale: è pensato per migliorare processi reali.
Riduzione dei tempi di debug, generazione prototipi in pochi secondi, creazione di app da testo.
Gemini diventa un tutor interattivo, capace di spiegare concetti difficili con esempi e visualizzazioni.
Automazione di report, individuazione anomalie, analisi predittive.
Google ha inserito Gemini 3.0 ovunque:
in Search, rendendo le ricerche più ricche e accurate,
in Gmail e Docs, dove crea riassunti e bozze,
in Sheets, per analisi dati avanzate,
in Android, con un assistente vocale più naturale,
in Google Cloud, dove è disponibile via API e su Vertex AI.
L’integrazione è così profonda che Gemini sta diventando il nuovo motore dell’intero ecosistema Google.
Nonostante le innovazioni, Lamborghini o Ferrari che sia, qualche limite rimane:
occasionali errori fattuali (anche se meno frequenti),
difficoltà nel ragionamento causale molto complesso,
costi elevati per la Deep Think Mode,
latenza maggiore su query molto pesanti.
Google ha dichiarato che questi aspetti saranno affrontati nelle versioni future, inclusa la già attesa Gemini 3.0 Ultra.
Google Gemini 3.0 è uno dei modelli più avanzati mai rilasciati, capace di combinare ragionamento, multimodalità, codice, agentività e creazione di interfacce.
I punti che lo rendono unico sono:
Deep Think Mode, che porta il ragionamento su un altro livello,
Multimodalità reale, che integra testo, immagini, video e dati,
Generative UI, che permette di creare strumenti completi da zero,
Prestazioni record nei benchmark,
Integrazione profonda nell’ecosistema Google.
Se l’obiettivo era ridefinire lo standard dell’intelligenza artificiale nel 2025, Google sembra averlo centrato in pieno.
Disclaimer
Pagina informativa realizzata con l’aiuto dell’intelligenza artificiale: non è consulenza finanziaria, né una raccomandazione di investimento, né promozione di prodotti o servizi. Il trading di CFD comporta un elevato rischio di perdita del capitale e i risultati passati non sono indicativi di quelli futuri. Dati e prezzi valgono alla data di pubblicazione. Possibili link di affiliazione: AmicoBot può ricevere una commissione, senza costi aggiuntivi per te. Segnalazioni di errori qui.
Nessuna tab disponibile.
Google Gemini 3.0 è l’ultima generazione di modelli AI sviluppati da Google. Offre una comprensione multimodale più precisa, capacità di ragionamento avanzato e strumenti agentici che permettono analisi complesse e creazione di interfacce.
La versione 3.0 introduce una nuova architettura Mixture of Experts, la Deep Think Mode per ragionamento profondo, potenziamento nella generazione di codice e una multimodalità molto più naturale tra testo, immagini, video e audio.
La Deep Think Mode attiva risorse extra del modello, consentendo ragionamenti multi-step più accurati. In pratica esegue controlli interni, valuta alternative e riduce errori logici durante la risposta.
Nei benchmark ufficiali Gemini 3.0 supera GPT-4 in ragionamento complesso, analisi visiva, generazione di codice e gestione del contesto, offrendo risposte più coerenti e meno soggette a hallucinations.
Sì, il modello elabora simultaneamente testo, immagini, video, audio, tabelle e grafici. Non solo li comprende, ma li integra per generare analisi o output coerenti e strutturati.
È la funzione che permette al modello di creare interfacce, mini-app, dashboard o strumenti interattivi semplicemente partendo da una richiesta testuale, senza che l’utente debba programmare.
Assolutamente sì. Google ha integrato il modello in IDE come VSCode e ha rilasciato la Gemini CLI, permettendo a sviluppatori e aziende di creare applicazioni e automatizzare workflow.
È utile nel coding, nella ricerca, nel marketing, nell’analisi dati, nella formazione, nel business intelligence e nella creazione contenuti. È progettato per adattarsi a contesti differenti.
Il nuovo modello include pipeline di auto-correzione, riduzione dei bias e verifiche interne di coerenza. Pur con qualche limite residuo, è significativamente più affidabile delle versioni precedenti.
Alcune risposte possono ancora contenere errori fattuali, e la Deep Think Mode richiede più potenza computazionale, causando un po’ di latenza. Anche il ragionamento causale in contesti molto tecnici può risultare complesso.
Scrivici su WhatsApp, ti diamo dati, prezzi e funzionamento dei prodotti che recensiamo. I criteri con cui li valutiamo sono pubblici in ogni scheda.