Risultati settimanali
Home > Blog > Tecniche previsionali delle serie temporali: cosa funziona davvero sui prezzi

Tecniche previsionali delle serie temporali: cosa funziona davvero sui prezzi

Tecniche previsionali delle serie temporali prima parte copertina ab

Medie mobili, smoothing esponenziale, ARIMA, GARCH, STL e machine learning: cosa stima ciascuna tecnica, come si comporta sui prezzi veri di S&P 500 ed EUR/USD dal 2016 a oggi e cosa hanno trovato le grandi gare di previsione.

Ultimo aggiornamento:
Indice contenuti

Scrivici su WhatsApp, ti diamo dati, prezzi e funzionamento dei prodotti che recensiamo. I criteri con cui li valutiamo sono pubblici in ogni scheda.

Introduzione

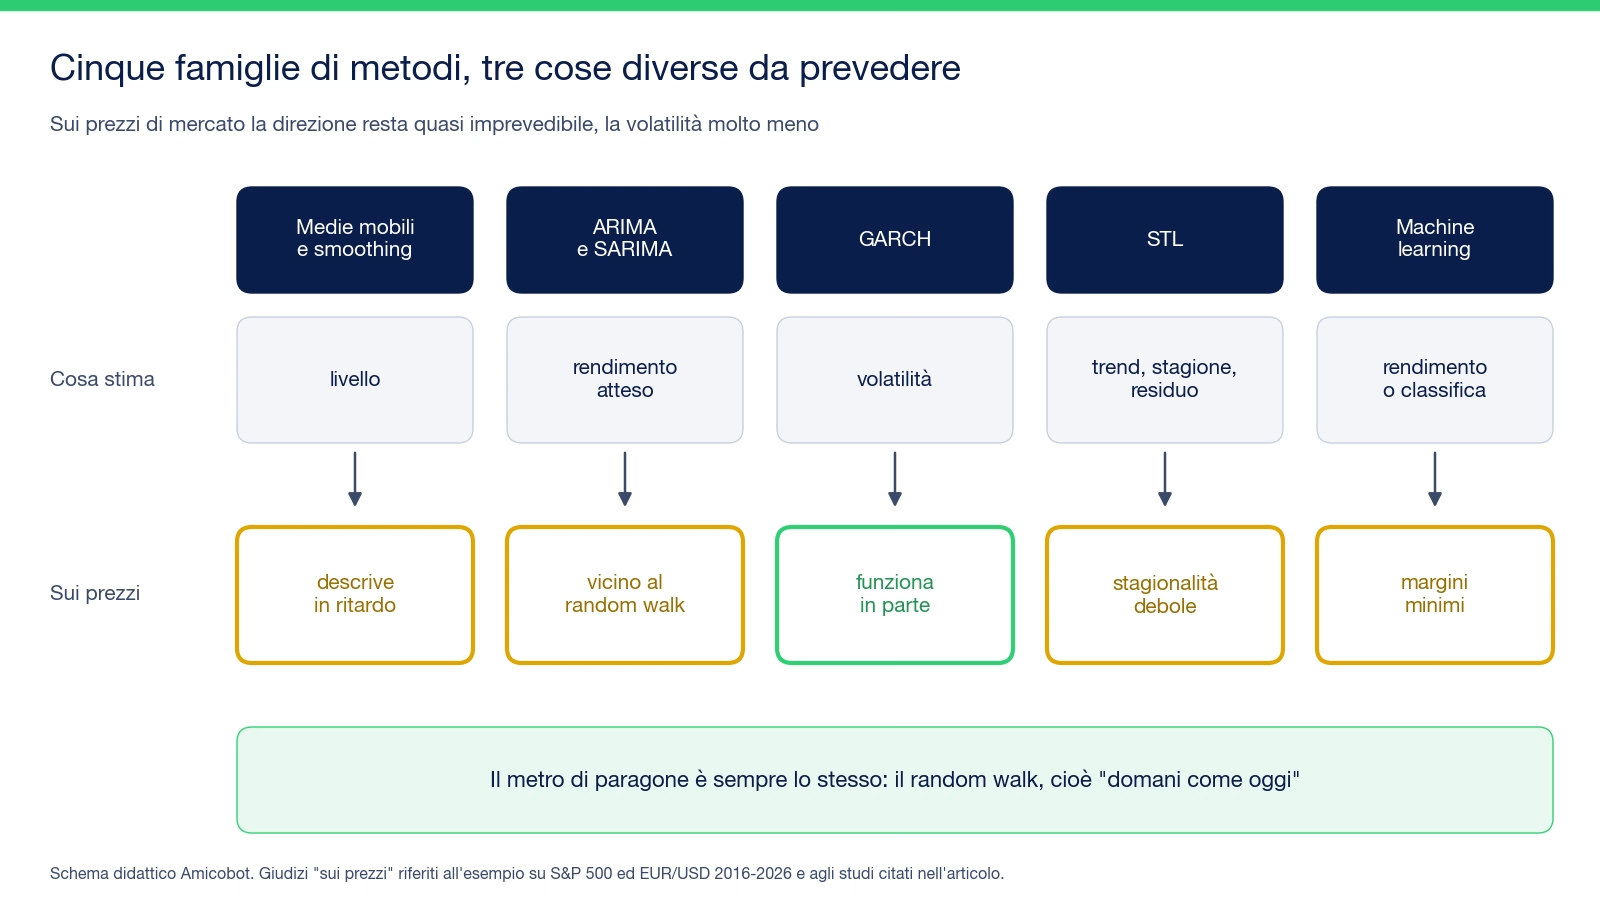
Le tecniche previsionali delle serie temporali stimano il valore futuro di un dato partendo dalla sua storia. Le famiglie principali sono cinque: medie mobili e smoothing esponenziale, ARIMA e SARIMA, GARCH, scomposizione STL, machine learning.

Sui prezzi di mercato il risultato è netto. La direzione del giorno dopo resta quasi imprevedibile: fuori campione nessuna tecnica si stacca in modo stabile dal random walk, la previsione più semplice possibile, “domani come oggi”. La volatilità invece si prevede in buona parte, ed è lì che questi modelli servono davvero.

Le prove sono due. Un test fatto su dieci anni di S&P 500 ed EUR/USD, con i numeri qui sotto. E le gare di previsione organizzate da Spyros Makridakis, l’ultima delle quali, la M6, era dedicata proprio ai mercati.

Schema delle cinque famiglie di metodi: medie mobili e smoothing stimano il livello e sui prezzi descrivono in ritardo; ARIMA e SARIMA stimano il rendimento atteso e restano vicini al random walk; GARCH stima la volatilità e funziona in parte; STL separa trend, stagione e residuo ma la stagionalità dei prezzi è debole; il machine learning stima rendimenti o classifiche con margini minimi

Perché i prezzi sono una serie temporale difficile

Una serie temporale è una sequenza di valori registrati a intervalli regolari: chiusure giornaliere, vendite mensili, temperature orarie. Prevederla vuol dire sfruttare una regolarità del passato che continua nel futuro.

Le vendite di un supermercato hanno regolarità forti: il sabato, dicembre, le promozioni. I prezzi di borsa ne hanno molte meno, per un motivo economico prima che statistico. Se una regolarità fosse evidente, qualcuno la sfrutterebbe e la farebbe sparire. È l’argomento dell’ipotesi dei mercati efficienti, e la sua versione statistica è la teoria del random walk: i movimenti successivi sono indipendenti fra loro.

Il primo passo pratico è passare dai prezzi ai rendimenti, cioè alle variazioni percentuali. Il prezzo di oggi è quasi uguale a quello di ieri, quindi qualunque modello sembra preciso sul prezzo. Lo ha scritto bene Lliane su Quantitative Finance Stack Exchange il 20 aprile 2020: il prezzo di ieri predice ottimamente quello di oggi, il rendimento di ieri dice poco su quello di oggi. Per questo i modelli si stimano sui rendimenti: sono una serie stazionaria, con media e varianza abbastanza stabili, che è l’ipotesi di partenza di quasi tutti i modelli matematici dei mercati.

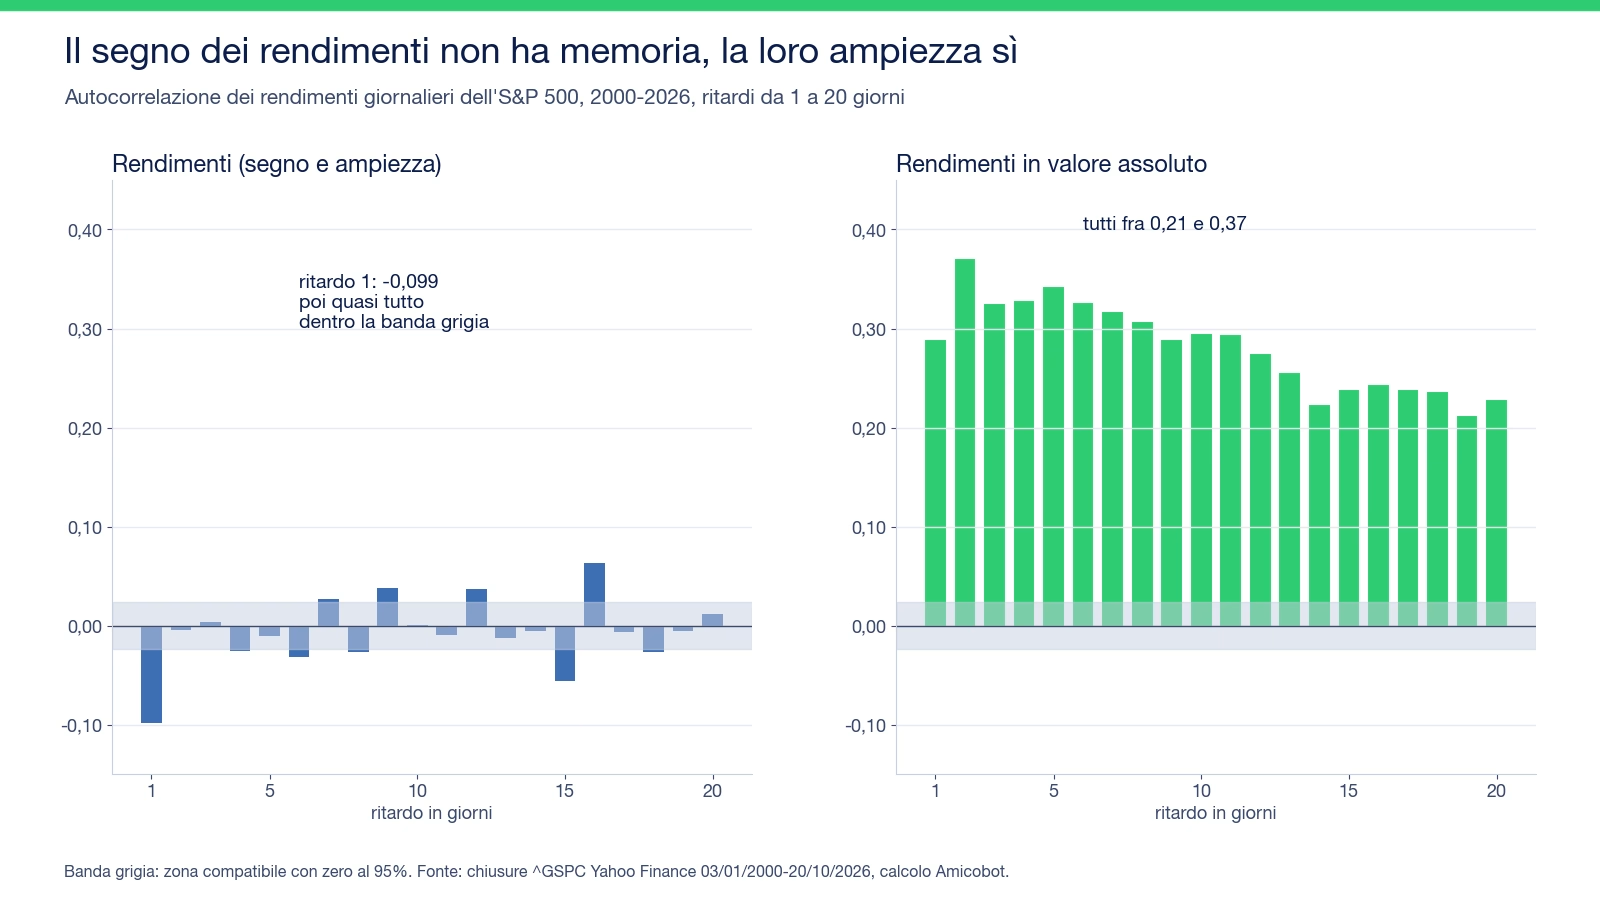
Il segno non ha memoria, l’ampiezza sì. L’autocorrelazione misura quanto un valore somiglia a quelli di uno, due, venti giorni prima. Sui rendimenti giornalieri dell’S&P 500 dal 2000 a oggi è quasi zero. Sui rendimenti presi in valore assoluto, cioè sull’ampiezza dei movimenti, è alta e dura settimane.

Due grafici a barre di autocorrelazione dell'S&P 500 2000-2026: a sinistra i rendimenti, con il ritardo 1 a -0,099 e quasi tutti gli altri dentro la banda grigia vicina a zero; a destra i rendimenti in valore assoluto, tutti fra 0,21 e 0,37 per venti giorni

Questo grafico riassume tutta la pagina. Le tecniche che cercano di prevedere la direzione lavorano sulla barra di sinistra, quasi vuota. Le tecniche che prevedono la volatilità lavorano su quella di destra, piena. La piccola barra negativa al primo giorno è un leggero rimbalzo del giorno dopo, concentrato nelle crisi: il terreno delle strategie di mean reversion.

Medie mobili e smoothing esponenziale

La media mobile semplice prevede il prossimo valore come la media degli ultimi N. Lo smoothing esponenziale fa la stessa cosa con pesi che calano man mano che i dati invecchiano: un parametro, alfa, decide quanto conta l’ultimo dato. Con alfa vicino a 1 la previsione coincide quasi con l’ultimo prezzo. La versione per il trading è la media mobile esponenziale.

Le varianti aggiungono pezzi. Holt aggiunge una componente di tendenza. Holt-Winters aggiunge anche la stagionalità. Nate per prevedere la domanda di magazzino, sono ancora tra i metodi più robusti quando la serie ha un livello che cambia lentamente.

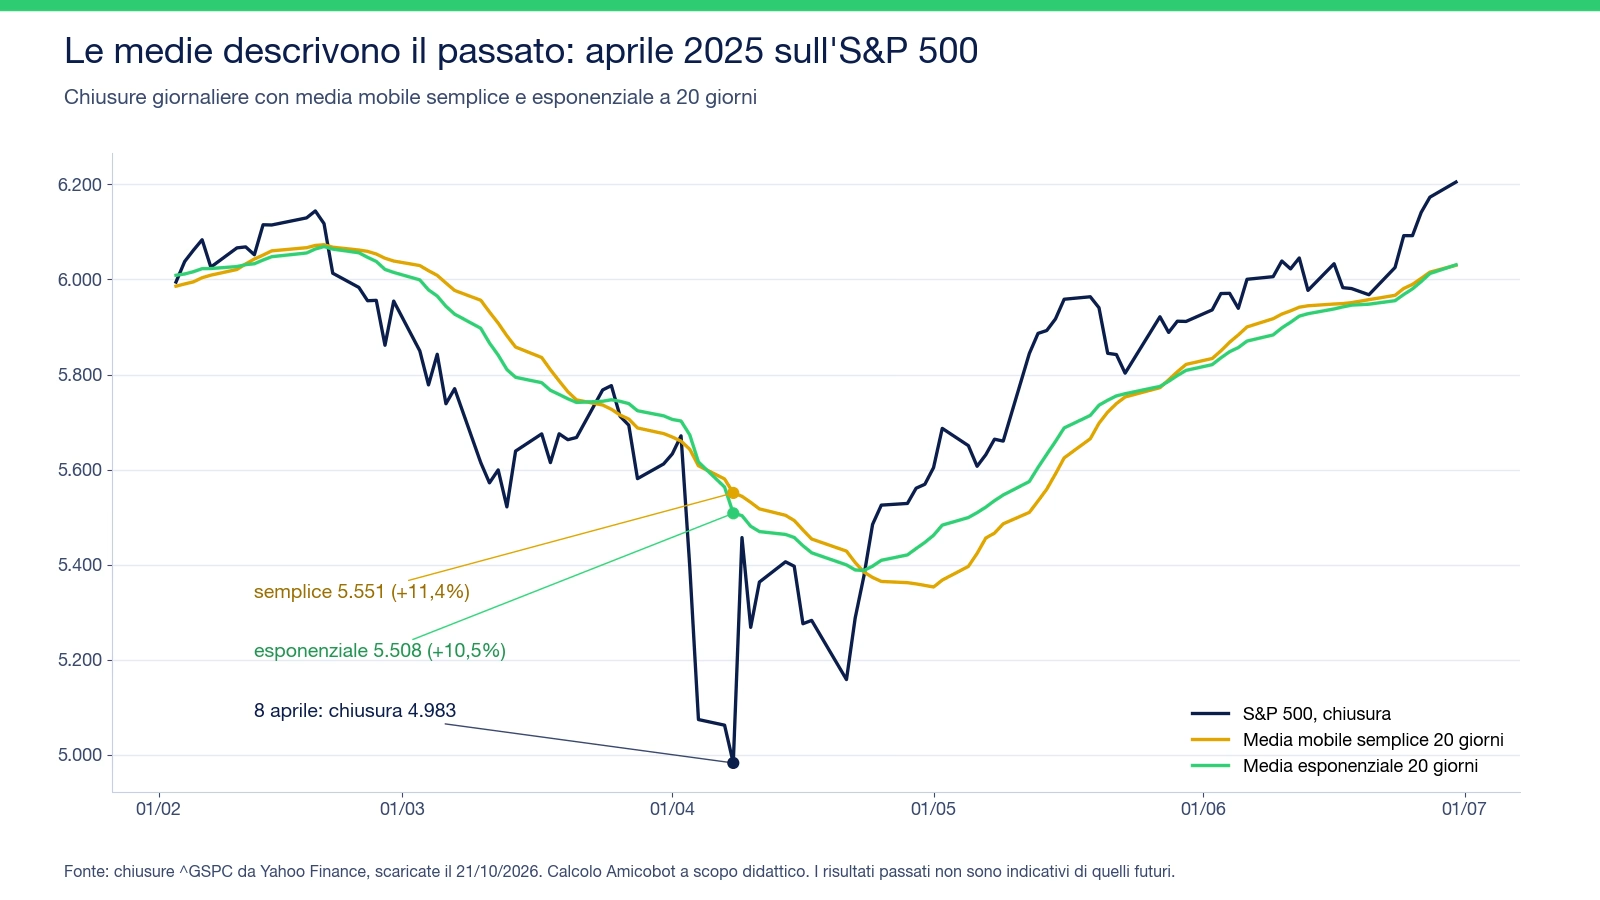
Sui prezzi hanno un limite strutturale: sono in ritardo per costruzione. Una media guarda indietro, quindi segue il movimento dopo che è avvenuto. Il caso di aprile 2025 lo mostra bene.

Grafico dell'S&P 500 da febbraio a giugno 2025 con media mobile semplice e media esponenziale a 20 giorni: l'8 aprile la chiusura è 4.983, la media semplice 5.551 (11,4% sopra) e quella esponenziale 5.508 (10,5% sopra)

L’S&P 500 è sceso da 6.144 punti il 19 febbraio 2025 a 4.983 l’8 aprile, un calo del 18,9% in sette settimane. Quel giorno la media semplice a 20 giorni valeva 5.551 e quella esponenziale 5.508. Lette come previsione, sbagliavano di oltre il 10%. Il 9 aprile l’indice è risalito del 9,5% in una seduta, e il prezzo è tornato sopra entrambe le medie solo il 24 aprile.

Lo stesso problema lo notano in molti appena applicano un modello a un grafico. @Esp1fs, sotto un tutorial ARIMA di DecisionForest su YouTube (2021 circa), scriveva che la linea di previsione sta sempre dietro al prezzo e arriva dopo i fatti. È il comportamento atteso: quando una serie si comporta come un random walk, la previsione migliore è l’ultimo valore, e una curva che ricopia l’ultimo valore sembra un prezzo spostato di un giorno.

Le medie restano utili per altro: descrivere la tendenza, filtrare il rumore, costruire regole di trading con la media mobile in cui il segnale non pretende di prevedere ma di seguire.

ARIMA e SARIMA

ARIMA sta per AutoRegressive Integrated Moving Average. Ha tre parametri, scritti (p, d, q):

  • p è il numero di valori passati usati nella regressione (parte autoregressiva);
  • d è quante volte si fa la differenza della serie per renderla stazionaria (sui prezzi di solito 1, che equivale a passare ai rendimenti);
  • q è il numero di errori di previsione passati che entrano nel modello (parte a media mobile, che non ha niente a che vedere con la media mobile del paragrafo prima).

SARIMA aggiunge gli stessi tre parametri per un ciclo stagionale, (P, D, Q) con periodo s: 12 per i dati mensili con ciclo annuale, 7 per i dati giornalieri con ciclo settimanale. Sulle vendite o sui consumi elettrici la componente stagionale è forte. Sui prezzi è debole e instabile: gli effetti di calendario esistono, ma sono piccoli e cambiano negli anni. Come usarli in una regola sta nella guida a bias e stagionalità.

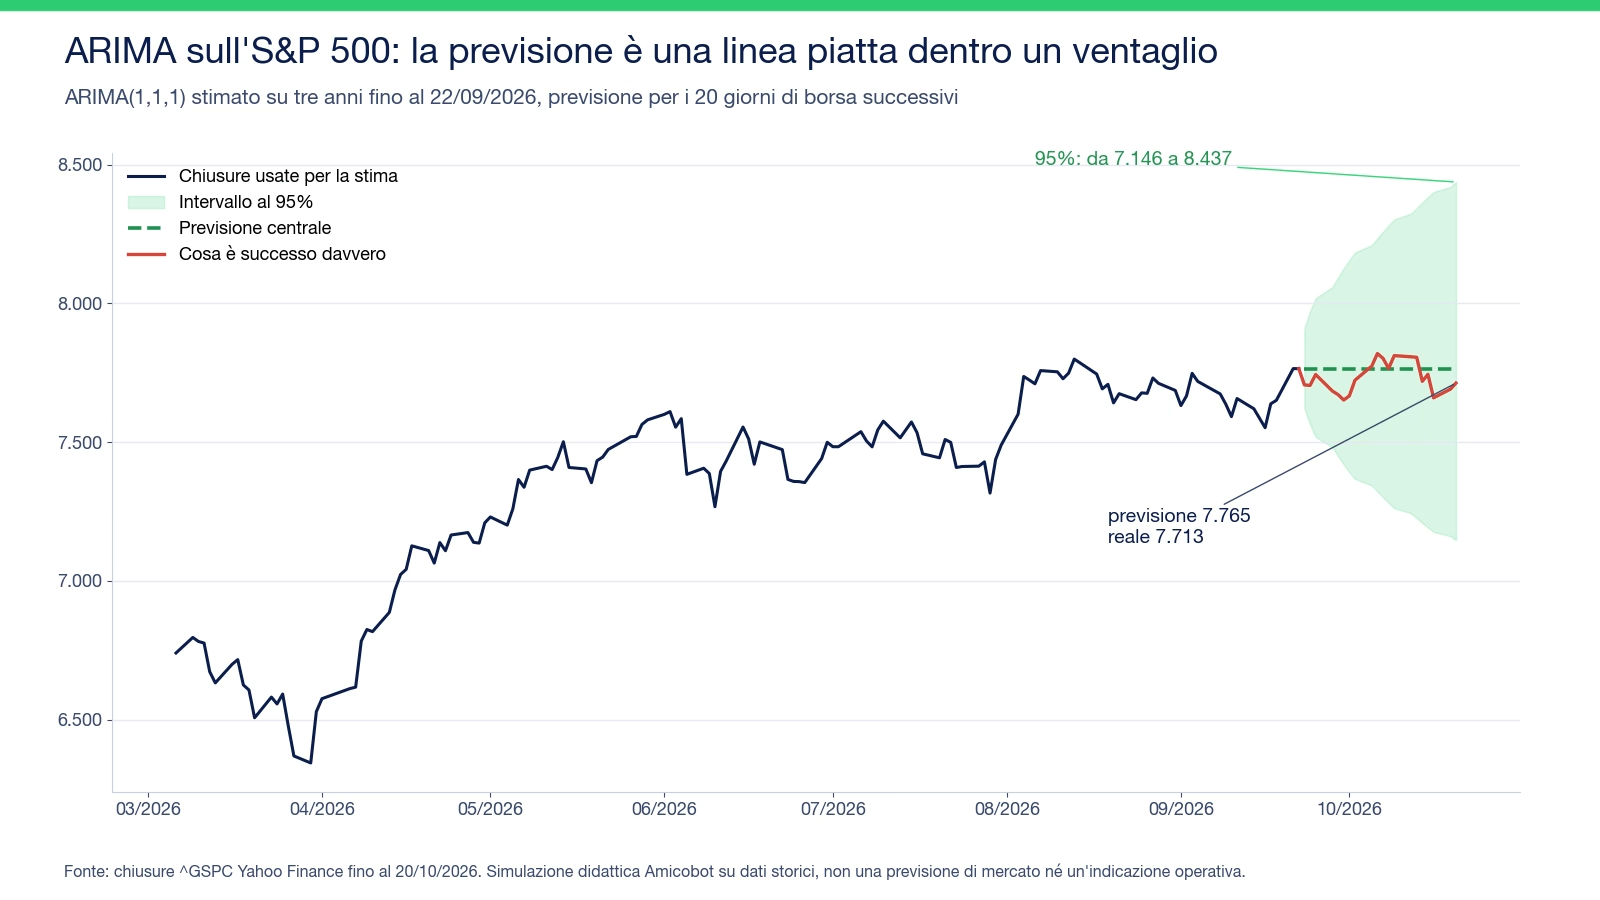
Perché la previsione esce piatta. È la domanda più frequente sotto i tutorial. @ashokkojha, sotto lo stesso video di DecisionForest (2025 circa), chiedeva cosa sbagliasse visto che otteneva sempre una previsione piatta. Souames, su Quantitative Finance Stack Exchange il 19 aprile 2020, raccontava che l’auto ARIMA sul titolo Netflix gli aveva dato “una linea dritta”. Non è un errore. È il modello che dice di non aver trovato niente da sfruttare.

Grafico dell'S&P 500 da marzo a ottobre 2026 con la previsione ARIMA(1,1,1) fatta il 22 settembre 2026: linea centrale piatta a 7.765 per venti giorni dentro un ventaglio che si allarga fino a 7.146-8.437; la chiusura reale del 20 ottobre è 7.713

Nell’esempio il modello è stato stimato su tre anni di chiusure fino al 22 settembre 2026. I coefficienti stimati sono praticamente zero, quindi la previsione centrale resta ferma a 7.765 punti per tutte le venti sedute successive. L’informazione utile sta nel ventaglio: al 95% l’indice doveva finire fra 7.146 e 8.437, una forbice di circa 1.300 punti. Il 20 ottobre ha chiuso a 7.713, dentro la forbice.

Simulazione su dati storici calcolata da Amicobot a scopo didattico, non una previsione di mercato. I risultati passati non sono indicativi di quelli futuri.

Il ventaglio però è disegnato con un’ipotesi di rendimenti normali. @lorarand, sotto un video di ritvikmath su YouTube (2023 circa), lo faceva notare: i rendimenti hanno code grasse, quindi gli intervalli di confidenza sottostimano la probabilità dei movimenti estremi. È la stessa ragione per cui i cigni neri arrivano più spesso di quanto dica la curva a campana.

Il test: cinque previsioni contro "domani come oggi"

Per uscire dagli esempi singoli, cinque metodi sono stati messi a confronto su dieci anni di dati che i modelli non avevano visto.

Come è costruito. Chiusure giornaliere da Yahoo Finance: S&P 500 dal 2000 e EUR/USD dal 2004 fino al 20-21 ottobre 2026. Ogni giorno si prevede il rendimento del giorno dopo. I parametri si stimano solo sui dati precedenti: periodo di stima fino al 2015, poi ARIMA ristimato ogni 1° gennaio su una finestra che si allunga. Il periodo di prova parte dal 2016: 2.715 giorni sull’S&P 500 e 2.811 sull’EUR/USD. La logica è quella della divisione fra dati in sample e out of sample.

I concorrenti: il random walk (rendimento previsto zero), la media storica dei rendimenti, la media mobile dei rendimenti a 20 giorni, lo smoothing esponenziale sul prezzo e un ARIMA(1,0,1) sui rendimenti.

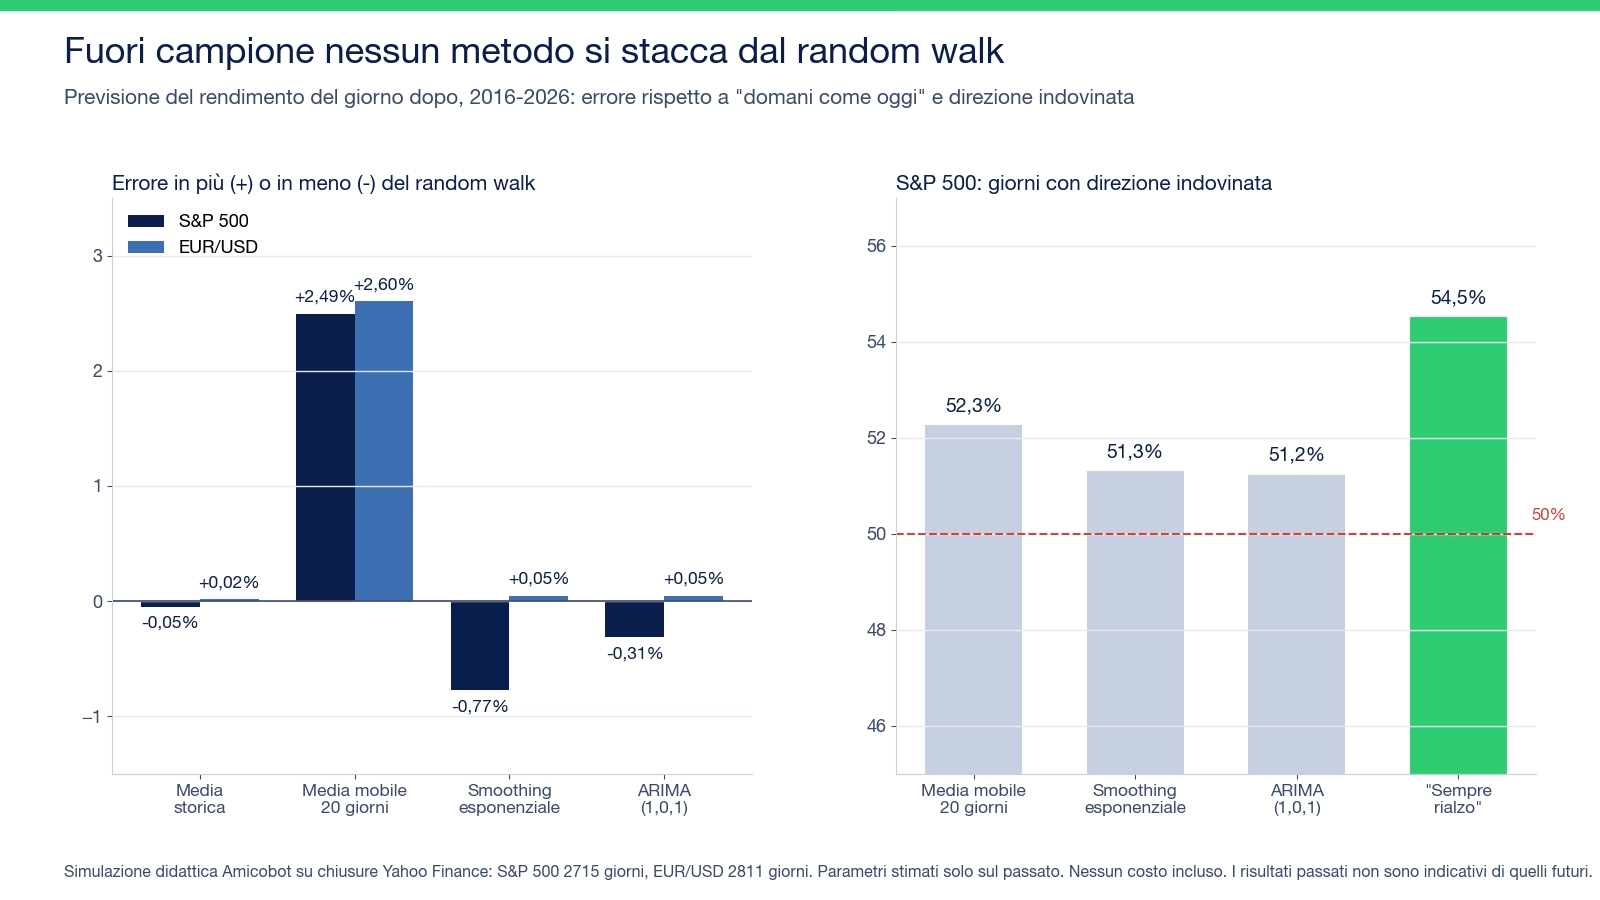
Due grafici: a sinistra l'errore di ogni metodo rispetto al random walk, fra -0,77% e +0,05% per media storica, smoothing e ARIMA, +2,49% e +2,60% per la media mobile a 20 giorni su S&P 500 ed EUR/USD; a destra la quota di giorni con direzione indovinata sull'S&P 500, 52,3%, 51,3% e 51,2% per i modelli contro il 54,5% della regola sempre rialzo

Sull’errore, nessuno si stacca. Sull’S&P 500 lo smoothing esponenziale riduce l’errore medio dello 0,77% rispetto al random walk e l’ARIMA dello 0,31%: briciole, che vengono quasi tutte dal piccolo rimbalzo dei giorni di crisi. Sull’EUR/USD tutti i metodi sono uguali o peggiori del random walk. La media mobile a 20 giorni peggiora l’errore di circa il 2,5% su entrambi i mercati, perché insegue un trend recente che il giorno dopo non c’è più.

Sulla direzione, vince la regola più stupida. I modelli indovinano il segno del giorno dopo fra il 51,2% e il 52,3% delle volte. Dire “domani sale” ogni giorno avrebbe indovinato il 54,5%, perché nel periodo l’S&P 500 è salito più spesso di quanto sia sceso. Un modello che indovina il 52% non batte nemmeno la frequenza dei rialzi.

Simulazione su dati storici calcolata da Amicobot a scopo didattico: nessun costo di transazione incluso, nessuna operazione reale. Le condizioni di esecuzione reali (spread, slippage, latenza) peggiorerebbero ogni regola operativa costruita su queste previsioni. I risultati passati non sono indicativi di quelli futuri.

Il risultato non è nuovo. Nel 1983 Richard Meese e Kenneth Rogoff, sul Journal of International Economics, hanno mostrato che per dollaro contro sterlina, marco e yen il random walk prevedeva i cambi a 1-12 mesi con la stessa accuratezza dei modelli economici e di serie temporali. Nel 2008 Ivo Welch e Amit Goyal, sulla Review of Financial Studies, hanno passato in rassegna le variabili usate in letteratura per prevedere il rendimento della borsa americana: deboli dentro e fuori campione, e inutili per fare market timing con le sole informazioni disponibili in tempo reale.

GARCH: la parte che si prevede davvero

Il GARCH (Generalized AutoRegressive Conditional Heteroskedasticity) non prevede dove andrà il prezzo. Prevede quanto si muoverà. Il modello più usato, GARCH(1,1), stima la varianza di domani con tre ingredienti: un livello di lungo periodo, lo shock di oggi e la varianza di oggi. È la traduzione matematica della barra piena del grafico sull’autocorrelazione: dopo un giorno agitato ne arriva spesso un altro agitato, in una direzione qualsiasi.

Fr1, rispondendo su Quantitative Finance Stack Exchange l’8 agosto 2019 a chi usava ARMA più GARCH per fare day trading, lo spiegava così: la parte GARCH non aiuta a prevedere la direzione, misura quanto il rendimento si allontanerà dalla previsione. Ed è per questo che è popolare nella gestione del rischio.

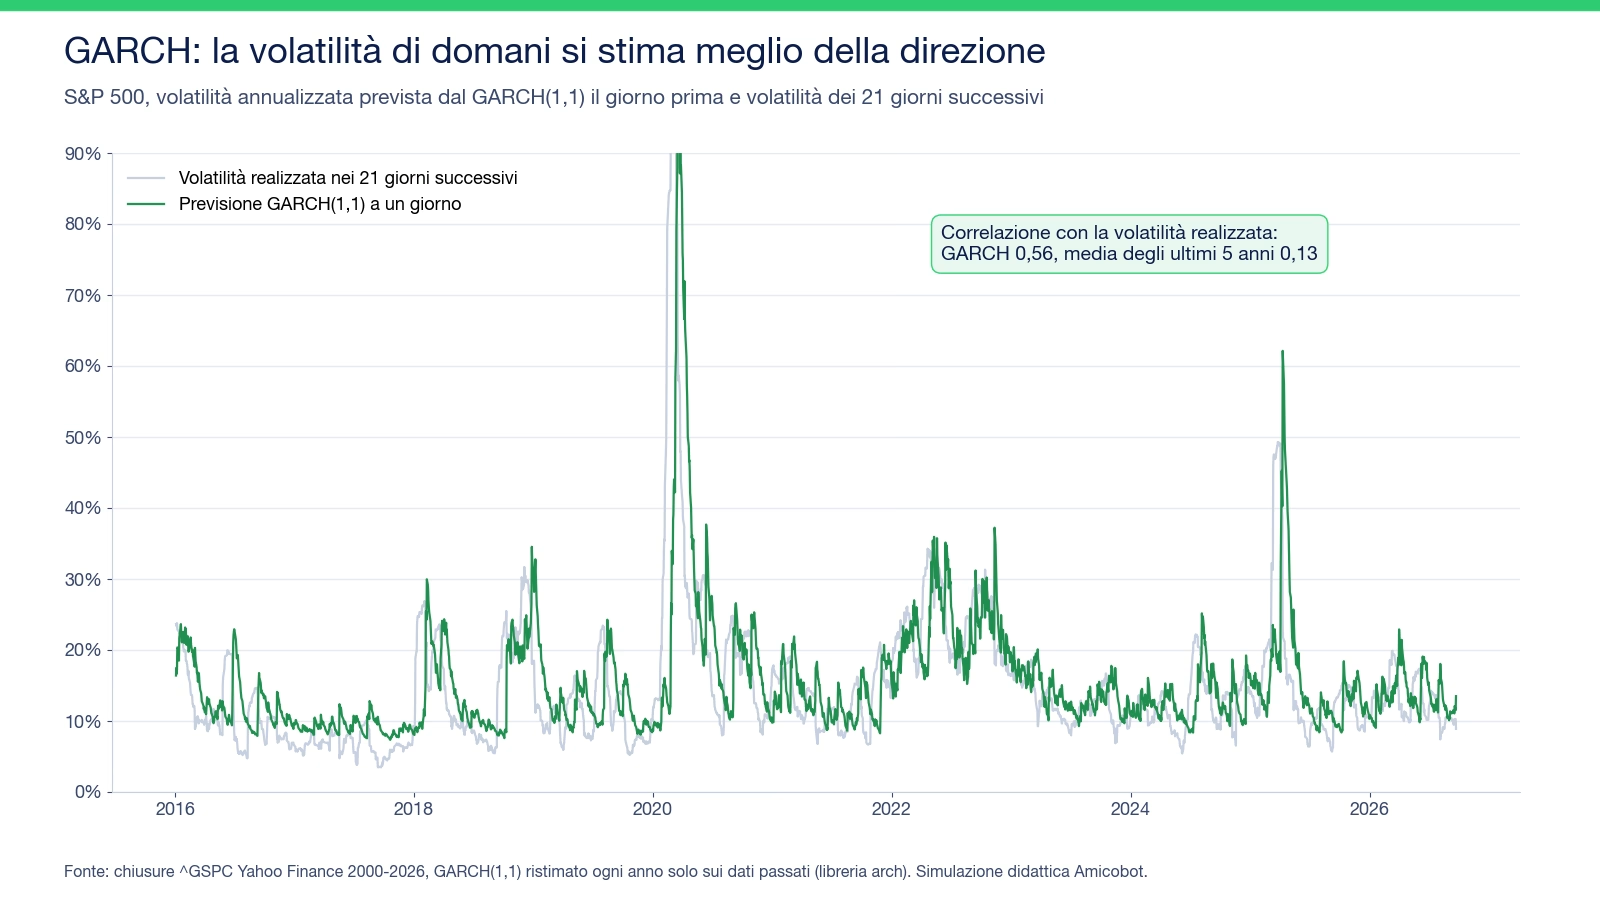
Grafico 2016-2026 della volatilità annualizzata dell'S&P 500: la previsione GARCH(1,1) a un giorno segue da vicino la volatilità realizzata nei 21 giorni successivi, con i picchi di marzo 2020 e aprile 2025; correlazione 0,56 contro 0,13 della media degli ultimi cinque anni

Nello stesso test, un GARCH(1,1) ristimato ogni anno sull’S&P 500 ha una correlazione di 0,56 fra la volatilità prevista il giorno prima e quella realizzata nelle 21 sedute successive. La deviazione standard degli ultimi cinque anni, la stima “statica” che molti usano, si ferma a 0,13. Il modello coglie in anticipo le fasi agitate di marzo 2020 e aprile 2025, anche se nei primi giorni di uno shock arriva in ritardo come qualunque stima basata sul passato.

Simulazione su dati storici calcolata da Amicobot a scopo didattico. I risultati passati non sono indicativi di quelli futuri.

Per chi usa sistemi automatici è la parte che serve: dimensionare le posizioni, allargare o stringere gli stop, ridurre l’esposizione quando la volatilità attesa sale. Come entra nella progettazione di un sistema lo racconta la guida sul rischio nel trading algoritmico.

STL: scomporre prima di prevedere

STL (Seasonal and Trend decomposition using Loess) separa una serie in tre pezzi: tendenza, stagionalità e residuo. Non è un modello di previsione da solo: si usa per pulire la serie, prevedere i pezzi separatamente e rimetterli insieme, o per trovare anomalie nel residuo.

Sulle serie economiche e aziendali funziona bene. Sui prezzi giornalieri la componente stagionale esce piccola e il residuo si prende quasi tutta la varianza: la scomposizione conferma che c’è poco da estrarre.

Machine learning e reti neurali

Il machine learning cerca relazioni non lineari fra molte variabili, invece di imporre una forma come fa l’ARIMA. Alberi di decisione, gradient boosting, reti neurali ricorrenti e, più di recente, modelli fondazionali addestrati su milioni di serie.

Le gare di Makridakis danno un quadro onesto. Nella M4 del 2018, 100.000 serie di cui 24.534 finanziarie, i sei metodi di solo machine learning sono andati male: nessuno ha battuto la combinazione di metodi statistici usata come riferimento. Ha vinto un ibrido fra smoothing esponenziale e rete neurale, circa il 10% più accurato del riferimento, e 12 dei 17 metodi migliori erano combinazioni di modelli statistici. Nella M5 del 2020, sulle vendite al dettaglio, hanno vinto i metodi di machine learning, soprattutto gli alberi di gradient boosting. La differenza la fanno i dati: molte serie correlate e variabili esterne come prezzi e promozioni.

Sui rendimenti di borsa il guadagno esiste ma è minuscolo. Lo studio più citato, Gu, Kelly e Xiu sulla Review of Financial Studies del 2020, ha usato circa 30.000 titoli americani dal 1957 al 2016 e 94 caratteristiche per titolo. Le reti neurali migliori spiegano fuori campione dallo 0,33% allo 0,40% della variazione mensile dei rendimenti. Una regressione lineare con tutte le 920 variabili fa -3,46%, cioè peggio di una previsione costante: più variabili non vuol dire più informazione, vuol dire più overfitting.

Anche nei prodotti retail il machine learning si usa più come filtro che come oracolo. Perceptrader AI di Valery Trading lavora con una griglia di ordini e usa un Perceptron per scartare le operazioni che non rispettano i parametri impostati. La scheda annota che con il filtro attivo il numero di operazioni cala, ma la loro qualità non migliora in modo sostanziale. Il quadro generale su questi prodotti è nella guida al trading automatico con intelligenza artificiale.

La gara M6: previsioni e portafogli dal vivo

La M6, la sesta gara della serie, è l’unica dedicata ai mercati. Fra febbraio 2022 e febbraio 2023 i partecipanti dovevano stimare, ogni mese, in quale quinto della classifica di rendimento sarebbero finiti 100 asset: 50 titoli dell’S&P 500 e 50 ETF internazionali. Dovevano anche costruire un portafoglio con quelle previsioni. La valutazione era dal vivo, sui dati che arrivavano dopo l’invio.

Il riferimento da battere era il più ingenuo possibile: dare a ogni asset la stessa probabilità di finire in ciascun quinto, cioè non prevedere niente.

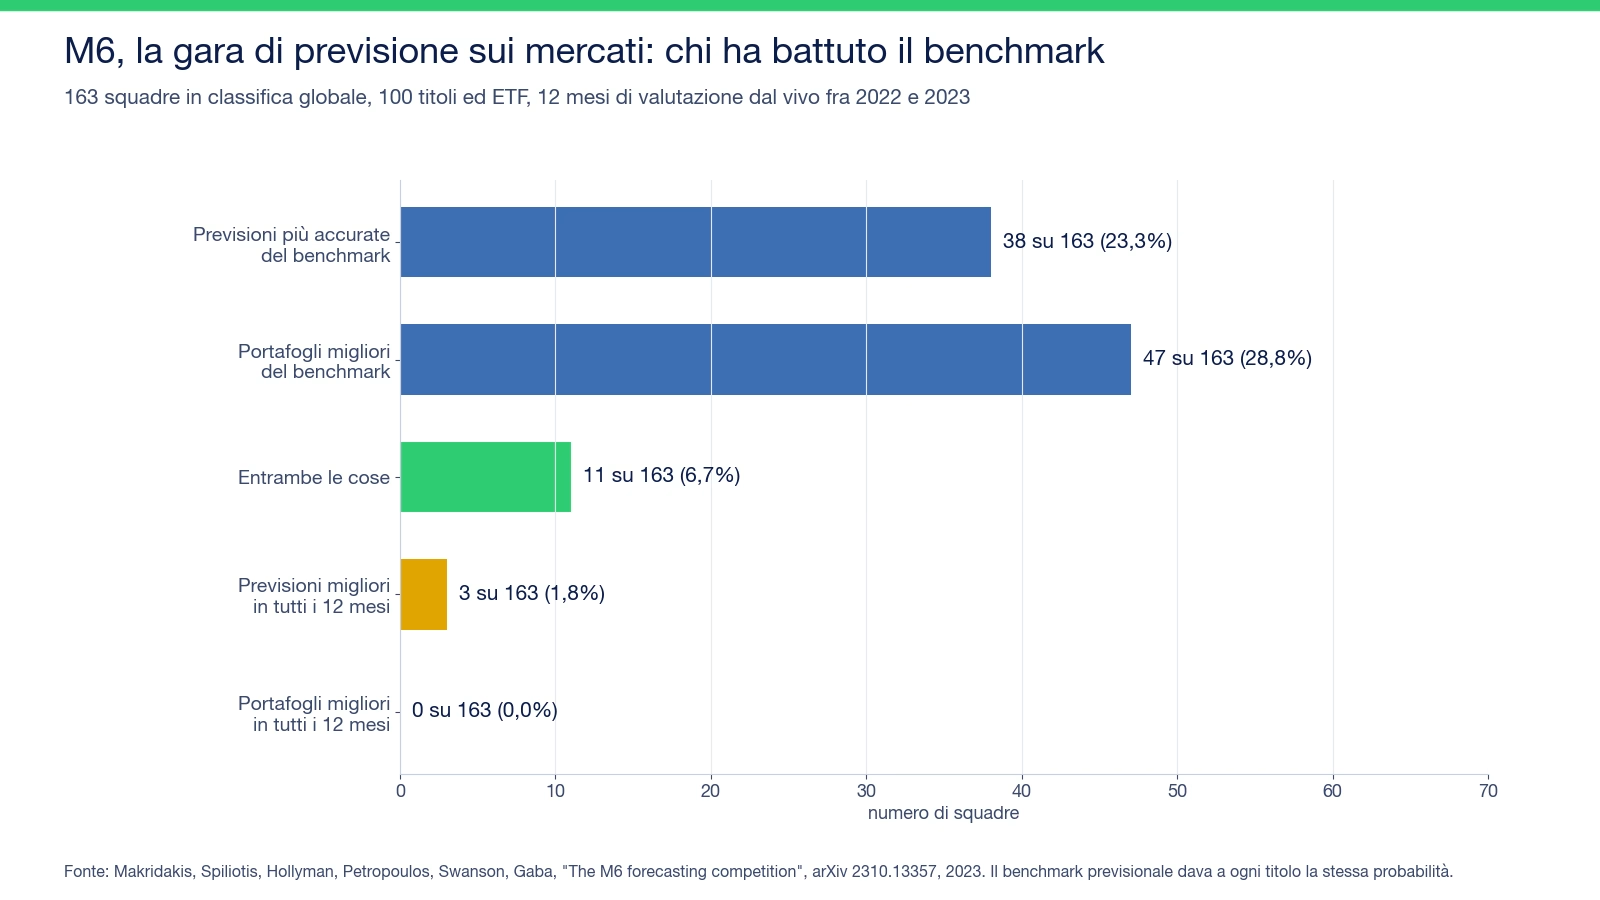
Grafico a barre della gara M6 su 163 squadre: 38 con previsioni più accurate del benchmark, 47 con portafogli migliori, 11 con entrambe le cose, 3 con previsioni migliori in tutti i 12 mesi e nessuna con portafogli migliori in tutti i 12 mesi

Delle 163 squadre in classifica globale, 38 (il 23,3%) hanno previsto meglio del riferimento ingenuo e 47 (il 28,8%) hanno costruito portafogli migliori. Solo 11 (il 6,7%) hanno fatto entrambe le cose. Appena 3 squadre hanno battuto il riferimento previsionale in tutti i 12 mesi, nessuna lo ha fatto sul portafoglio.

Il dato più interessante riguarda il legame fra le due cose. Gli autori non hanno trovato una connessione chiara fra accuratezza delle previsioni e qualità degli investimenti: le squadre migliori nelle previsioni costruivano in media portafogli poco efficienti, e viceversa. Prevedere un po’ meglio non basta, se la previsione non entra in un controllo del rischio. È la stessa distanza che separa un modello statistico da un sistema di trading quantitativo completo.

Cosa raccontano gli utenti che ci hanno provato

Sotto i tutorial e nei forum di finanza quantitativa tornano tre scoperte, quasi sempre nello stesso ordine. Raccolta del 21 ottobre 2026: 65 commenti sotto due video YouTube molto visti su ARIMA e ARMA applicati alle azioni e 10 interventi su Quantitative Finance e Cross Validated di Stack Exchange. Circa 40 commenti YouTube erano ringraziamenti o richieste del codice e non sono contati fra le voci.

La previsione piatta o in ritardo. È la prima sorpresa, già vista sopra con @ashokkojha, @Esp1fs e Souames. Chi arriva dalla regressione classica si aspetta una curva che anticipa il prezzo e ottiene una retta o una copia spostata.

Il test fatto male. @danielb.74, sotto il video di DecisionForest (2024 circa), faceva notare che il tutorial non divideva i dati fra stima e verifica, la regola base dell’analisi delle serie temporali. @TheNinjaDwarfBiker, sotto il video di ritvikmath (2023 circa), notava che comprare all’apertura non è lo stesso prezzo di chiusura su cui il modello era stato stimato: un dettaglio di esecuzione che in un test cambia il risultato.

La risposta secca. Alla domanda su quali modelli prevedano i prezzi delle azioni, Stelios Kounis rispondeva su Quantitative Finance Stack Exchange il 14 giugno 2020: “Long story short no”. Aggiungeva che i modelli da provare sono infiniti, e che trovarne uno che arricchisce è nel migliore dei casi un tiro lungo.

Commenti e opinioni dichiarati dagli utenti, non verificati. Le date YouTube sono ricavate dall’indicazione relativa della piattaforma.

Come si giudica una previsione prima di fidarsi

Chi costruisce o valuta un modello su una serie di prezzi può controllare quattro cose, in quest’ordine.

  1. Il confronto con il random walk. Un modello vale solo per quanto batte “domani come oggi” su dati che non ha visto. Un errore basso in assoluto non dice niente.
  2. Il confronto con la frequenza di base. Una direzione indovinata il 52% delle volte va messa accanto alla quota di giorni in rialzo del periodo. Nell’esempio era il 54,5%.
  3. La stabilità nel tempo. Il modello va ristimato e verificato a finestre successive, come nell’ottimizzazione walk forward. Un vantaggio che c’è solo in un periodo è una coincidenza.
  4. I costi. Un miglioramento dello 0,3% sull’errore di previsione sparisce con lo spread di una sola operazione.

Lo stesso schema vale per gli expert advisor che dichiarano di “prevedere” il mercato: la domanda giusta non è quanto è sofisticato il modello, ma contro quale riferimento è stato misurato e su quali dati.

Fonti e metodo

Studi letti il 21 ottobre 2026: Makridakis, Spiliotis, Hollyman, Petropoulos, Swanson e Gaba, “The M6 forecasting competition: Bridging the gap between forecasting and investment decisions”, arXiv 2310.13357, 2023; Makridakis, Spiliotis e Assimakopoulos, “The M4 Competition: Results, findings, conclusion and way forward”, International Journal of Forecasting 34(4), 2018; Oreshkin e altri, N-BEATS, arXiv 1905.10437, per la composizione delle serie M4; Meese e Rogoff, Journal of International Economics 14, 1983; Welch e Goyal, Review of Financial Studies 21(4), 2008; Gu, Kelly e Xiu, “Empirical Asset Pricing via Machine Learning”, NBER working paper 25398. Per la M5 sono state lette sintesi secondarie, non il paper dei risultati.

Esempio: chiusure giornaliere da Yahoo Finance di S&P 500 (dal 3 gennaio 2000 al 20 ottobre 2026) ed EUR/USD (dal 2 gennaio 2004 al 21 ottobre 2026), scaricate il 21 ottobre 2026. Calcoli con le librerie Python statsmodels e arch, parametri stimati solo sui dati precedenti a ogni previsione. È una simulazione didattica di Amicobot, non un sistema di trading e non un’indicazione operativa su indici o valute.

Questa pagina non contiene link di affiliazione.

Disclaimer

Pagina informativa realizzata con l’aiuto dell’intelligenza artificiale: non è consulenza finanziaria, né una raccomandazione di investimento, né promozione di prodotti o servizi. Il trading di CFD comporta un elevato rischio di perdita del capitale e i risultati passati non sono indicativi di quelli futuri. Dati e prezzi valgono alla data di pubblicazione. Possibili link di affiliazione: AmicoBot può ricevere una commissione, senza costi aggiuntivi per te. Segnalazioni di errori qui.

Facebook
X
Telegram
WhatsApp

Nessuna tab disponibile.

Nessuna. Sono tre nomi per la stessa cosa: una sequenza di osservazioni ordinate nel tempo a intervalli regolari. In statistica italiana si dice più spesso “serie storica”, nei testi di informatica e machine learning “serie temporale” o “time series”. Quello che conta è la frequenza: giornaliera, mensile, oraria, perché cambia quali regolarità si possono cercare.

Il valore di d si sceglie con un test di stazionarietà, per esempio il test ADF: si differenzia finché la serie non ha più una tendenza. Per p e q si guardano i grafici di autocorrelazione e autocorrelazione parziale della serie differenziata, oppure si provano più combinazioni e si sceglie quella con il criterio AIC o BIC più basso, come fanno le funzioni auto ARIMA. Sui rendimenti di borsa spesso il modello scelto è vicino a (0, 1, 0), cioè al random walk.

I più usati sono gratuiti. In Python le librerie statsmodels per ARIMA, SARIMA e smoothing esponenziale, e arch per i modelli GARCH. In R il pacchetto forecast, con la funzione auto.arima, e rugarch per la volatilità. Anche alcuni strumenti di business intelligence e BigQuery di Google hanno funzioni ARIMA integrate. Excel ha lo smoothing esponenziale, non l’ARIMA completo.

Dipende dai dati. Con migliaia di serie correlate e variabili esterne, come nelle vendite al dettaglio della gara M5, i metodi di machine learning hanno vinto. Con una sola serie breve e rumorosa, come un prezzo, i modelli statistici semplici o le loro combinazioni sono stati più accurati nella gara M4. Sui rendimenti azionari lo studio di Gu, Kelly e Xiu trova un vantaggio delle reti neurali, ma con un potere esplicativo mensile sotto lo 0,5%.

Servono soprattutto per la parte di rischio. Una stima della volatilità attesa, per esempio da un GARCH o da una media dell’ATR, aiuta a dimensionare le posizioni e a regolare gli stop. Usare un ARIMA per decidere la direzione delle operazioni si scontra con il problema visto nel test: un vantaggio statistico minimo che i costi di esecuzione cancellano. Come è fatto un sistema automatico completo lo spiega la guida su come funziona un robot di trading.

Scrivici su WhatsApp, ti diamo dati, prezzi e funzionamento dei prodotti che recensiamo. I criteri con cui li valutiamo sono pubblici in ogni scheda.

Ti potrebbe piacere anche
Gruppo Telegram

Gruppo Telegram

✕
Canale Telegram