Risultati settimanali
Home > Blog > Data augmentation nel trading automatico: le tecniche, cosa conservano e dove ingannano

Data augmentation nel trading automatico: le tecniche, cosa conservano e dove ingannano

Data augmentation nel trading automatico copertina ab

La data augmentation è l’insieme delle tecniche che creano dati nuovi partendo da quelli che si hanno già. Nel trading vuol dire generare serie di prezzo sintetiche: storie di mercato che non sono successe ma che somigliano a quella vera. Si usano per due lavori diversi. Il primo è misurare il rischio e la fortuna di un sistema su più storie possibili. Il secondo è dare più esempi a un modello di machine learning, che con pochi dati impara a memoria.

Ultimo aggiornamento:
Indice contenuti

Scrivici su WhatsApp, ti diamo dati, prezzi e funzionamento dei prodotti che recensiamo. I criteri con cui li valutiamo sono pubblici in ogni scheda.

Introduzione

C’è un limite che vale per tutte le tecniche: i dati sintetici non contengono informazione nuova. Rimescolano o imitano quella dello storico. Se la tecnica rompe una proprietà del mercato vero, il sistema viene provato su un mercato che non esiste. Questa pagina mostra quali proprietà conserva ogni tecnica, con una prova su 26 anni di S&P 500.

Le quattro famiglie di tecniche

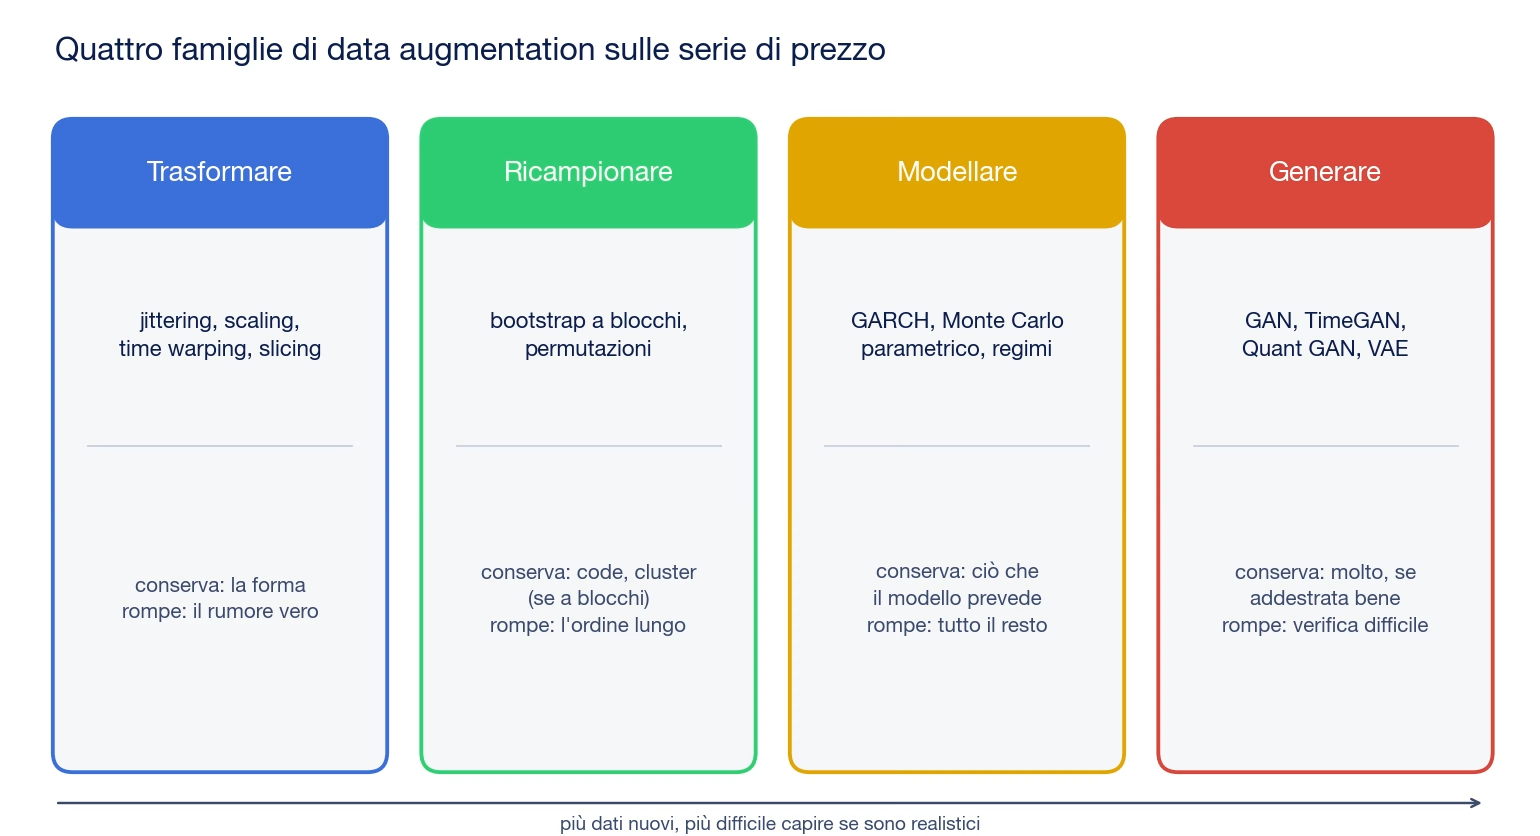
Le rassegne accademiche dividono i metodi in modo simile. Quella di Wen e colleghi, presentata a IJCAI 2021, separa le trasformazioni semplici dai metodi avanzati: decomposizione, modelli statistici e reti neurali generative. Per un trader conviene ragionare su quattro famiglie.

Schema delle quattro famiglie di data augmentation sulle serie di prezzo: trasformare, ricampionare, modellare, generare, con quello che ogni famiglia conserva e quello che rompe

Trasformare. Si prende la serie vera e la si modifica poco. Il jittering aggiunge un piccolo rumore casuale ai prezzi. Lo scaling cambia l’ampiezza dei movimenti. Il time warping accelera o rallenta alcuni tratti. Lo slicing ritaglia finestre più corte. Sono le tecniche nate per le immagini e l’audio, e sulle serie temporali funzionano meno di quanto si creda. Brian Kenji Iwana e Seiichi Uchida ne hanno provate dodici su 128 dataset di classificazione, con sei tipi di rete neurale (PLoS ONE, luglio 2021). Window warping e slicing hanno aiutato più spesso. Rotazione, permutazione e time warping hanno peggiorato l’accuratezza in modo significativo: la permutazione rompe l’ordine nel tempo. I risultati, scrivono gli autori, sono “mixed”: su alcune reti quasi ogni tecnica ha fatto danni. Quei dataset non sono finanziari, ma il segnale è chiaro.

Ricampionare. Si costruisce una serie nuova pescando pezzi della serie vera. Il bootstrap semplice ripesca i rendimenti giornalieri uno alla volta. Il bootstrap a blocchi ripesca interi tratti di più giorni. La versione più usata è lo stationary bootstrap di Dimitris Politis e Joseph Romano (Journal of the American Statistical Association, 1994): i blocchi hanno lunghezza casuale, così la serie ricostruita resta stabile nelle sue proprietà.

Modellare. Si stima un modello matematico sui dati veri e lo si fa girare. Il Monte Carlo parametrico usa una distribuzione, di solito la normale, con la stessa media e la stessa oscillazione dei rendimenti. Un modello GARCH aggiunge la volatilità che cambia nel tempo. Il modello conserva solo quello che gli si chiede di conservare.

Generare. Una rete neurale impara la forma dei dati e ne produce di nuovi. Le GAN mettono in gara due reti: una genera le serie, l’altra prova a distinguerle da quelle vere. È la famiglia che promette di più ed è anche la più difficile da verificare. Le reti neurali generative tornano più avanti, con i numeri dei due studi più citati.

La prova su 26 anni di S&P 500: cosa conserva ogni tecnica

Per vedere le differenze servono dati veri. Abbiamo preso le chiusure giornaliere dell’S&P 500 dal 3 gennaio 2000 al 15 ottobre 2026, cioè 6.736 rendimenti, dalla API pubblica di Yahoo Finance. Da questa serie abbiamo generato 1.000 storie sintetiche con tre metodi, tutte della stessa lunghezza:

  • Normale: rendimenti casuali con la stessa media e la stessa deviazione standard dello storico (il Monte Carlo parametrico);
  • Bootstrap giorno per giorno: rendimenti veri ripescati uno alla volta;
  • Bootstrap a blocchi: tratti veri di lunghezza casuale, in media 20 giorni di borsa.

Poi abbiamo confrontato tre proprietà che il mercato vero ha e che Rama Cont ha raccolto fra i “fatti stilizzati” dei rendimenti (Quantitative Finance, 2001): le code grasse, la memoria della volatilità e le discese profonde.

Proprietà S&P 500 reale Normale Giorno per giorno Blocchi di 20 giorni
Curtosi in eccesso (code grasse) 10,7 0,0 10,4 10,4
Giorni con un calo oltre il 5% 20 0 20 19
Memoria della volatilità dopo 1 giorno 0,29 0,00 0,00 0,27
Memoria della volatilità dopo 10 giorni 0,30 0,00 0,00 0,17
Memoria della volatilità dopo 50 giorni 0,13 0,00 0,00 0,01

Valori mediani su 1.000 serie per metodo. Calcolo didattico Amicobot su dati pubblici, letto il 16/10/2026.

Perché la normale sottostima i crolli. La curtosi misura quanto sono frequenti i movimenti estremi rispetto a una curva normale. Nell’S&P 500 è 10,7: i giorni violenti sono molto più comuni di quanto la normale preveda. Nelle storie generate con la normale, il numero mediano di giorni sotto il meno 5% è zero, contro 20 nella storia vera. Un sistema provato su quei dati non incontra mai un cigno nero. Il bootstrap invece ripesca i giorni veri, crolli compresi, e li conserva.

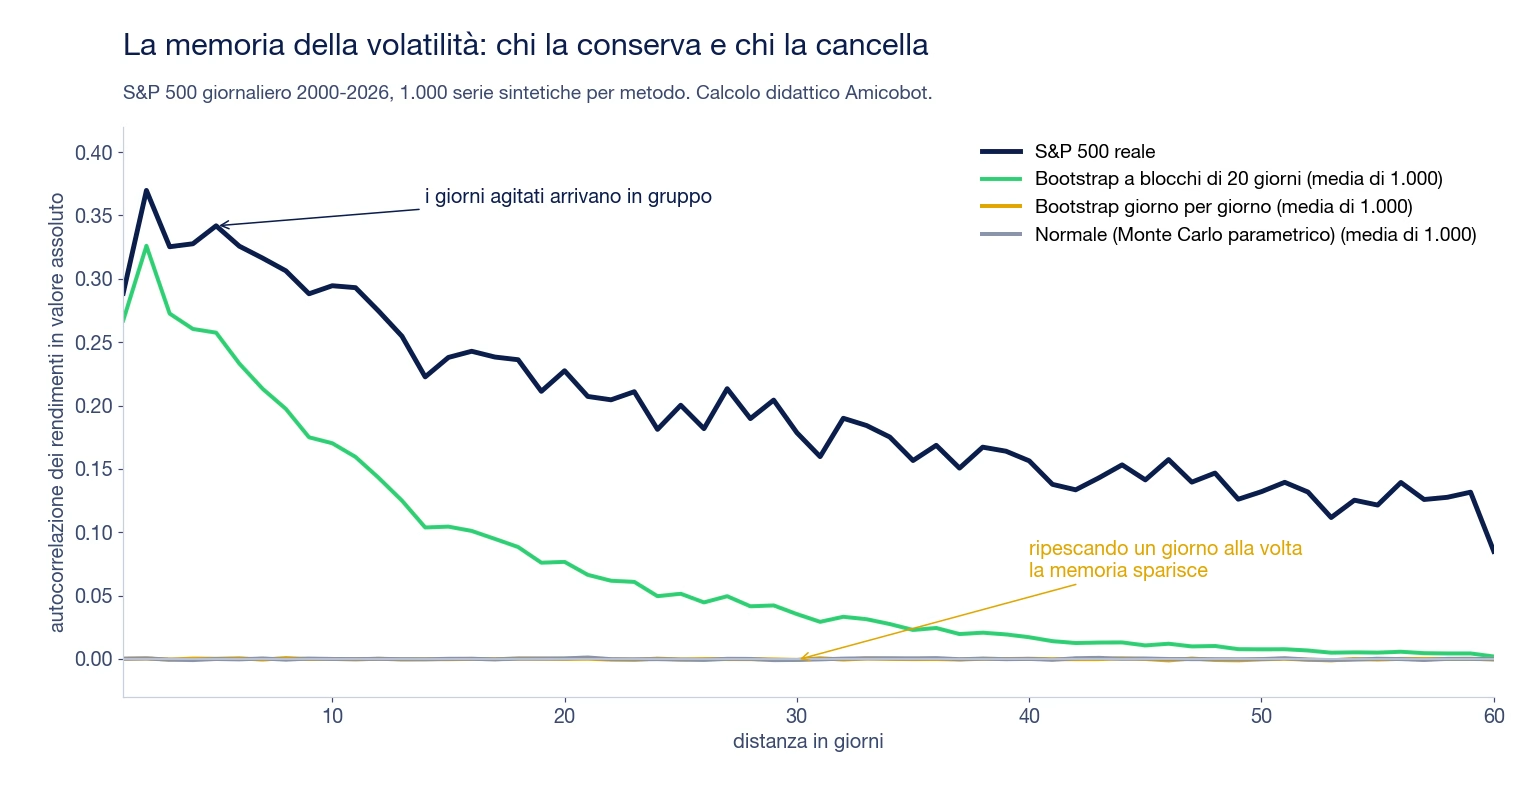
La memoria della volatilità. Nel mercato vero i giorni agitati arrivano in gruppo. Dopo un giorno con un movimento ampio, è più probabile un altro giorno con un movimento ampio. Si misura con l’autocorrelazione dei rendimenti presi in valore assoluto, cioè senza il segno. Il grafico mostra cosa succede.

Grafico dell'autocorrelazione dei rendimenti in valore assoluto dell'S&P 500 2000-2026 fino a 60 giorni: la serie reale resta sopra 0,1, il bootstrap a blocchi parte vicino e scende a zero dopo 40 giorni, bootstrap giorno per giorno e normale sono piatti a zero

Il bootstrap giorno per giorno conserva le code ma cancella la memoria: ogni giorno è pescato a caso, quindi i periodi agitati si sparpagliano. Il bootstrap a blocchi la conserva fino alla lunghezza dei blocchi, poi la perde. Oltre i 40 giorni anche lui è quasi a zero, mentre il mercato vero ricorda ancora. Nessun metodo conserva tutto. La scelta dipende da quale proprietà conta per il sistema che si vuole provare.

Cosa cambia per un sistema: le discese possibili

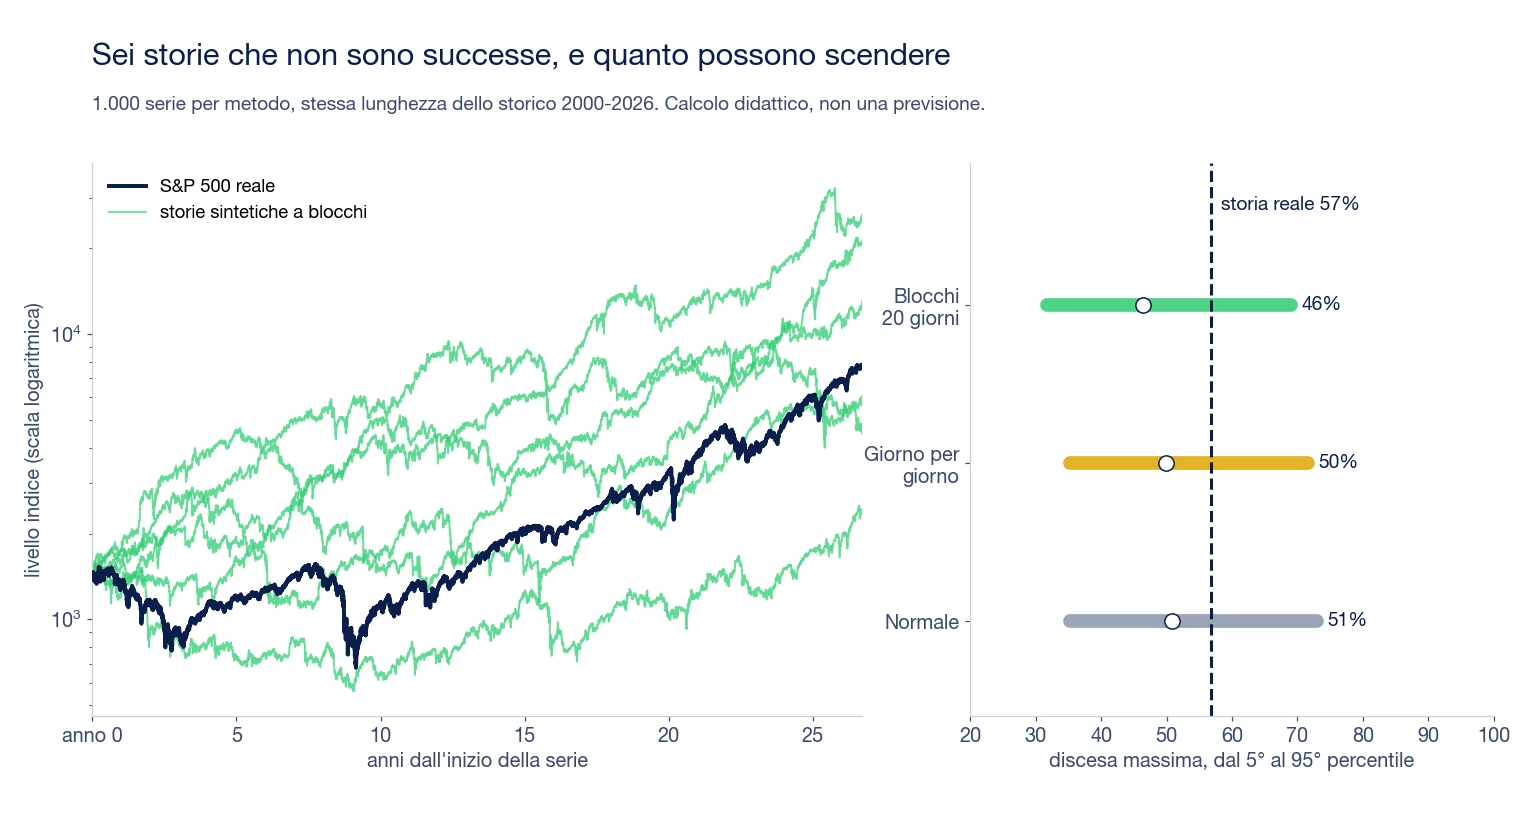
Le storie sintetiche servono soprattutto a una domanda: quanto poteva andare peggio? Sulla serie vera il drawdown massimo dell’indice è stato il 56,8%, fra il 2007 e il 2009. Sulle 1.000 storie a blocchi la discesa massima va dal 31,7% al 69,1% fra il 5° e il 95° percentile, con una mediana del 46,5%. In parole semplici: una storia su venti scende più del 69%.

A sinistra la curva reale dell'S&P 500 dal 2000 e sei storie sintetiche a blocchi in scala logaritmica; a destra l'intervallo della discesa massima dal 5° al 95° percentile per i tre metodi, con la linea della storia reale al 57%

Dati storici dell’indice e simulazioni su dati storici, senza dividendi. Non sono una previsione: i risultati passati non sono indicativi di quelli futuri.

Il grafico dice anche una cosa meno ovvia. La storia vera sta sopra la mediana di tutti e tre i metodi. Il crollo del 2008 è arrivato concentrato, in mesi di volatilità altissima uno dopo l’altro. Le storie sintetiche spezzano quel grappolo e la discesa si diluisce. Chi usa queste simulazioni per fissare uno stop sull’equity rischia di sottostimare proprio il caso peggiore. Le regole per decidere quando fermare un sistema stanno nella guida su quando staccare un trading system.

Il jittering: poco rumore, effetti non banali

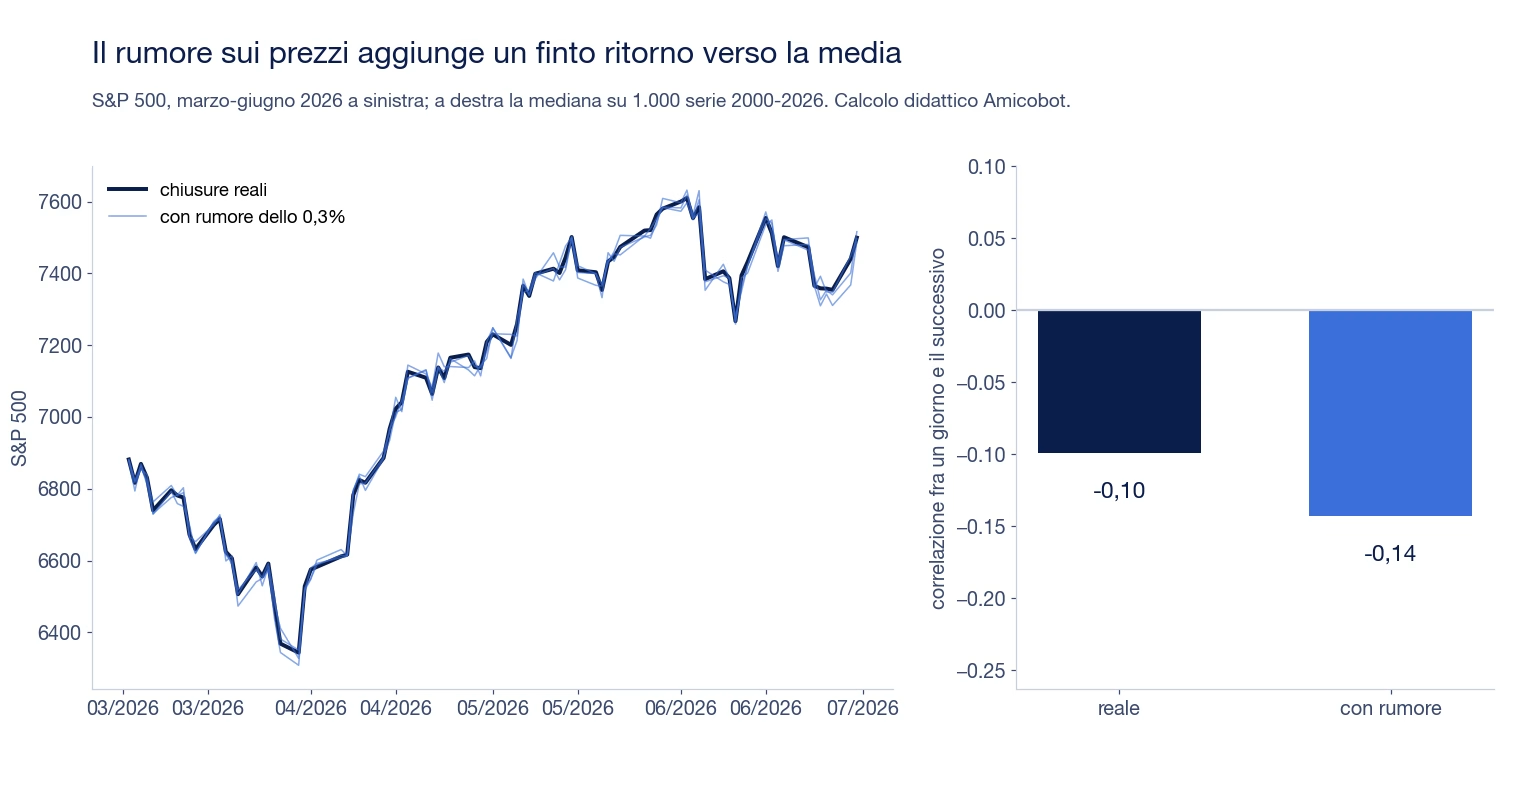
Il jittering sembra la tecnica più innocua. Si aggiunge ai prezzi un rumore piccolo e si ottengono serie quasi identiche. Nella prova abbiamo aggiunto a ogni chiusura un rumore casuale dello 0,3%, meno di un terzo dell’oscillazione giornaliera tipica dell’indice.

A sinistra le chiusure reali dell'S&P 500 fra marzo e giugno 2026 con tre versioni disturbate da un rumore dello 0,3%; a destra la correlazione fra un giorno e il successivo, meno 0,10 nella serie reale e meno 0,14 con il rumore

Due effetti. Il primo: il rumore sul livello del prezzo crea un finto ritorno verso la media. Se oggi il rumore spinge il prezzo su, domani il rendimento tende a tornare giù. La correlazione fra un giorno e il successivo passa da meno 0,10 a meno 0,14. Un sistema mean reversion di breve periodo troverebbe in quei dati un vantaggio che il mercato vero non offre. Il secondo: i segnali cambiano. La strategia sulla media mobile semplice a 200 giorni incrocia il prezzo 171 volte nella serie vera e 187 volte, in mediana, nelle serie disturbate. Sono 16 operazioni in più, tutte nate dal rumore.

Il jittering ha senso quando si vuole sapere se un sistema regge piccole differenze di prezzo, per esempio fra un broker e l’altro. Non ha senso come fonte di “nuovi mercati”.

L'uso più solido: il test di permutazione

C’è un uso dei dati sintetici che ribalta la prospettiva. Invece di chiedere “come andrebbe il sistema su altri mercati”, si chiede “un risultato così poteva uscire per caso?”. Si generano storie in cui il vantaggio che si sta cercando è stato distrutto apposta, e si guarda quante volte il sistema ottiene comunque il risultato della storia vera. È il test di permutazione, reso popolare fra i trader dai libri di Timothy Masters.

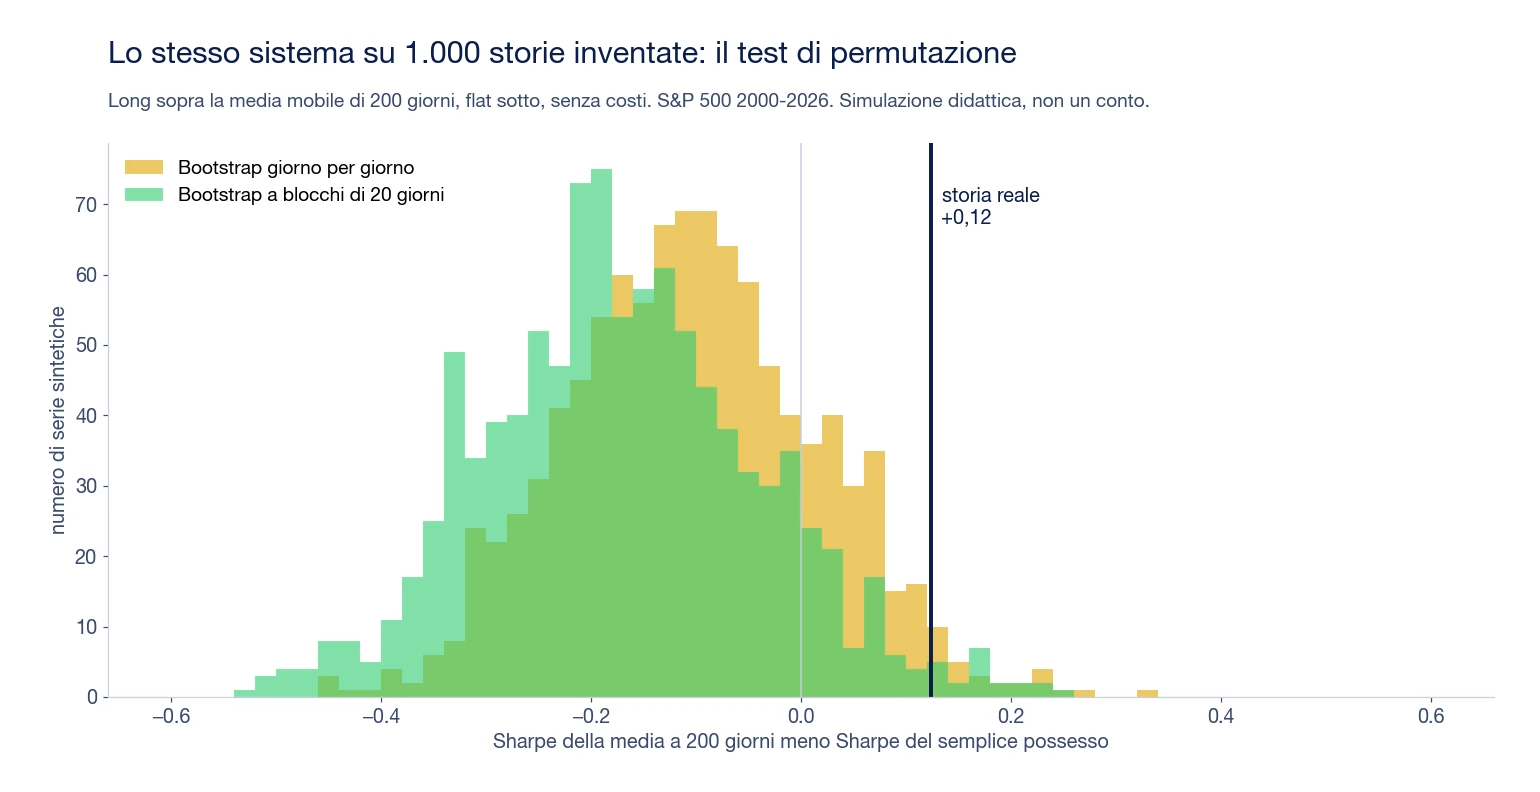
Nella prova il sistema è semplice e scelto prima di guardare i dati: comprato quando l’indice sta sopra la media mobile a 200 giorni, fuori quando sta sotto. Sulla serie vera lo Sharpe ratio del sistema supera quello del semplice possesso di 0,12. Le storie ricampionate hanno lo stesso andamento medio e la stessa volatilità, ma l’ordine dei movimenti è rotto.

Istogramma del vantaggio di Sharpe della media mobile a 200 giorni sul semplice possesso, su 1.000 storie ricampionate giorno per giorno e 1.000 a blocchi: la maggior parte delle storie è sotto zero, la storia reale è a più 0,12 nella coda destra

Solo il 2,7% delle storie ricampionate giorno per giorno arriva a un vantaggio uguale o maggiore. Con i blocchi la quota è il 2,0%. Detto in modo semplice: se il vantaggio fosse frutto del caso, un risultato così uscirebbe circa due o tre volte su cento.

Simulazione su dati storici dell’S&P 500 03/01/2000-15/10/2026, senza costi, spread e dividendi. Non è un conto reale e non indica come operare. I risultati passati non sono indicativi di quelli futuri.

Tre limiti da tenere accanto al numero. Un test solo non prova un vantaggio futuro. Se si provano cento sistemi, qualcuno passerà il test per caso: è il meccanismo dell’overfitting. E il risultato dipende dalla storia scelta: lo stesso sistema su un altro mercato può non passare, come mostra l’esempio sull’oro nella guida a progettare un trading system.

Monte Carlo sui trade o sulle serie? Sono due cose diverse. Il Monte Carlo sui trade rimescola le operazioni già chiuse di un backtest o di un conto: misura quanto il drawdown dipende dall’ordine, ma non cambia i segnali. Quello sulle serie rigenera i prezzi e rifà girare il sistema, quindi cambiano anche le operazioni. Il primo è spiegato con un esempio su 600 operazioni reali nell’analisi Montecarlo. Un’idea veloce si ottiene con il simulatore Montecarlo.

Data augmentation e machine learning: dove serve davvero

Nel machine learning la data augmentation nasce per un motivo pratico. Una rete neurale ha migliaia di parametri. Con dieci anni di candele giornaliere ha circa 2.500 esempi, e li impara a memoria. Le tecniche di questa pagina servono a dare più varietà durante l’addestramento.

I due studi più citati sulle serie finanziarie dicono cose utili, anche nei loro limiti.

TimeGAN di Jinsung Yoon, Daniel Jarrett e Mihaela van der Schaar (NeurIPS 2019) è stata provata anche sulle azioni Google giornaliere dal 2004 al 2019. Gli autori hanno addestrato un classificatore a distinguere le serie vere da quelle generate. Il punteggio che ne esce è 0,102 per TimeGAN e 0,196 per il metodo concorrente migliore: più il numero è basso, più il classificatore fatica a riconoscere le serie finte. Poi hanno addestrato un modello di previsione solo sui dati sintetici e l’hanno provato su quelli veri. L’errore è stato 0,038, contro 0,036 dello stesso modello addestrato sui dati veri.

Quant GAN di Magnus Wiese e colleghi (Quantitative Finance, 2020) ha generato percorsi dell’S&P 500 dal maggio 2009 al dicembre 2018, 2.413 giorni. Le serie generate riproducono cluster di volatilità, effetto leva e autocorrelazioni meglio di un modello GARCH. Gli autori però scrivono che l’addestramento è stato “molto irregolare” e non ha raggiunto un ottimo: hanno salvato più versioni e scelto la migliore con un punteggio. È un dettaglio che conta. Una rete che genera dati va a sua volta validata, e quella scelta è un altro passaggio dove l’overfitting può entrare.

Per chi valuta un expert advisor già pronto, la conseguenza è concreta. Molti venditori dichiarano un modulo di intelligenza artificiale, quasi nessuno dice su quali dati l’ha addestrato. Perceptrader AI usa reti neurali di tipo Perceptron per filtrare gli ingressi di una griglia. Nella sua scheda si legge che, nelle prove con i moduli AI attivi, il numero di operazioni scendeva ma la qualità non migliorava in modo sostanziale. Dark Nebula dichiara un algoritmo di machine learning su dati storici di prezzo e indicatori macro, su EUR/USD e GBP/USD. Con VENUS LABS, che sviluppa Dark Nebula, Amicobot ha un rapporto commerciale: fornisce anche la VPS usata da Amicobot. In entrambi i casi la pagina del prodotto non dice se l’addestramento ha usato dati sintetici. Il controllo che resta possibile è lo storico reale accumulato dopo il lancio, letto come spiegato nella guida a valutare un track record.

L’approccio opposto esiste e va citato. Gold Breaker usa sette strategie breakout sull’oro con parametri interni bloccati, che l’utente non può ottimizzare. Meno libertà di adattarsi ai dati vuol dire anche meno bisogno di nutrire il sistema con dati inventati. Il quadro generale su modelli e limiti dell’AI applicata ai mercati è nella guida al trading automatico con intelligenza artificiale. Per i modelli che imparano per tentativi, dove la generazione di scenari è parte del metodo, c’è la pagina sul reinforcement learning.

L'errore che invalida tutto: i dati sintetici dentro la verifica

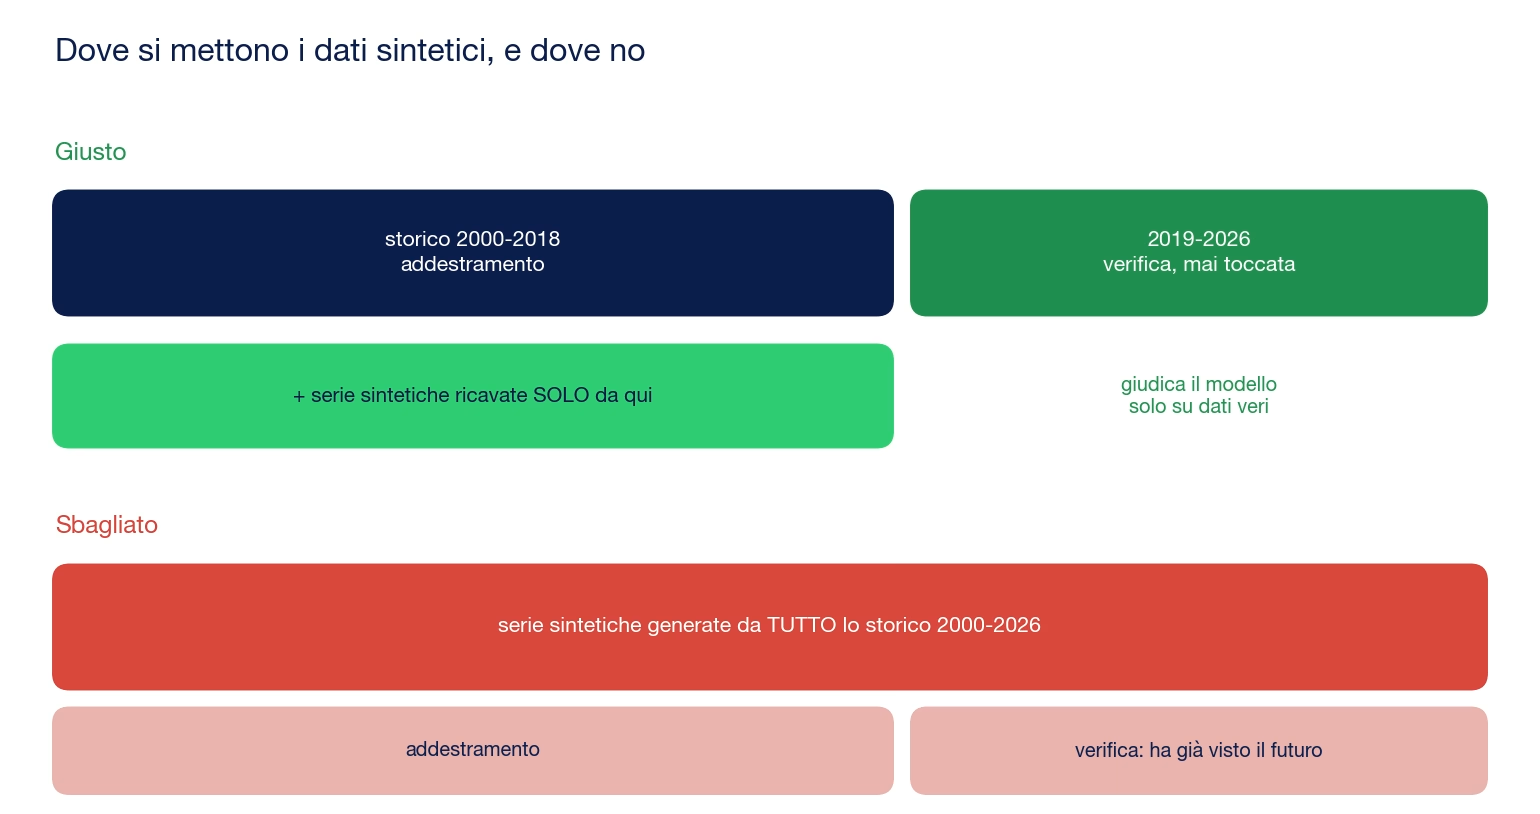
Il modo più comune di sbagliare non riguarda la tecnica. Riguarda da quale periodo si generano i dati.

Schema corretto e sbagliato: nel caso giusto le serie sintetiche sono ricavate solo dal periodo di addestramento 2000-2018 e la verifica 2019-2026 resta su dati veri mai toccati; nel caso sbagliato le serie sono generate da tutto lo storico e la verifica ha già visto il futuro

Se le serie sintetiche vengono generate da tutto lo storico, contengono pezzi del periodo che dovrebbe servire per la verifica. Un bootstrap a blocchi ripesca proprio quei tratti. Il modello viene giudicato su un futuro che ha già visto, e il risultato è gonfiato. La regola è semplice: prima si divide lo storico, poi si generano i dati solo dalla parte di addestramento, e la verifica si fa solo su dati veri. Come dividere lo storico è spiegato nella guida su in sample e out of sample. Il metodo che ripete la divisione nel tempo è il walk forward. Quanto le metriche reggono passando dal test al reale è il tema di persistenza e validazione.

I dati sintetici sono uno strumento della robustezza di un trading system, non un sostituto della verifica fuori campione.

Come si fa su MetaTrader 5

Fino a qualche anno fa provare un EA su prezzi inventati richiedeva un software apposito. Oggi MetaTrader 5 ha i simboli personalizzati. Il manuale della piattaforma dice che possono essere usati per testare robot e indicatori nello Strategy Tester, e che i prezzi si importano da un file di testo. Su un simbolo personalizzato non si può fare trading reale.

Il percorso, in pratica:

  1. si generano le serie sintetiche fuori da MetaTrader, per esempio in Python, e si salvano in CSV con data, ora, apertura, massimo, minimo, chiusura, volume tick, volume e spread;
  2. si crea un simbolo personalizzato copiando le proprietà di quello vero (contratto, cifre, orari);
  3. si importano le barre del file;
  4. si lancia il test sul nuovo simbolo, come spiegato nella guida al backtest su MetaTrader, e si ripete per ogni serie.

Un dettaglio che il bootstrap sui rendimenti di chiusura non risolve: le candele hanno anche massimo e minimo. Se si generano solo le chiusure, i livelli di stop e take profit dentro la candela vanno ricostruiti, e ogni ricostruzione è un’ipotesi. Con un bootstrap a blocchi sulle candele intere il problema si riduce, perché si ripescano barre vere.

Cosa ne pensano i trader che li hanno provati

Il 16 ottobre 2026 abbiamo letto 97 messaggi: un thread del forum MQL5 sul test degli EA con quotazioni sintetiche e i commenti a due video YouTube, uno sui dati simulati e uno sui test di permutazione. Quasi tutti i commenti erano complimenti generici. Uno era la promozione di un exchange e non lo contiamo. Le voci con un contenuto erano undici, e queste sono le più utili.

Utente Piattaforma e data Cosa dice
Michele Lazzarini Forum MQL5, 29 luglio 2014 Propone di testare gli EA come si testano i circuiti: quotazioni sintetiche con ampiezza, frequenza e rumore che cambiano, invece dei soli dati storici
Stanislav Korotky Forum MQL5, 29 luglio 2014 Allora MT5 non permetteva storici personalizzati. Non crede che i dati artificiali interessino molto ai trader
Young Ho Seo Forum MQL5, 4 agosto 2014 Se i dati sintetici non hanno le proprietà del prezzo vero, la simulazione “non rivela nulla”. Il Monte Carlo sulla variabilità storica copre una proprietà sola
@nielsou2 YouTube, video di QuantProgram, ottobre 2025 circa Dubita che il moto browniano usato nel video pesi abbastanza gli eventi di coda
@jordi18ss YouTube, stesso video, ottobre 2025 circa Chiede se non sia meglio una distribuzione con code più grasse della normale
@muhireinnocent2371 YouTube, stesso video, ottobre 2024 circa Chiede come unire dati simulati e reali per addestrare un modello senza rompere l’ordine nel tempo
@alrey72 YouTube, stesso video, ottobre 2025 circa Si chiede perché simulare quando esistono già prezzi veri di azioni, materie prime e valute
@lawrenceobioma YouTube, video di neurotrader, ottobre 2025 circa I test su più mercati aiutano con alcuni problemi dei test di permutazione
@Andreas-sd4pr YouTube, stesso video, dicembre 2025 circa Dopo tutto il walk forward serve un ultimo test su dati mai visti

Date YouTube ricavate dall’indicazione relativa della piattaforma. Opinioni degli utenti, non verificate.

Le critiche di Young Ho Seo e di @nielsou2 sono le stesse che la prova sull’S&P 500 misura: la normale non ha code e i dati sintetici valgono quanto le proprietà che conservano. La domanda di @muhireinnocent2371 è il problema del leakage visto sopra. E la risposta alla domanda di @alrey72 sta nel test di permutazione: i prezzi veri dicono cosa è successo, solo le storie alternative dicono se poteva succedere per caso.

Fonti e metodo

Studi letti il 16 ottobre 2026: Wen e altri, “Time Series Data Augmentation for Deep Learning: A Survey”, IJCAI 2021; Iwana e Uchida, PLoS ONE 16(7), 2021; Yoon, Jarrett e van der Schaar, NeurIPS 2019; Wiese, Knobloch, Korn e Kretschmer, Quantitative Finance, 2020. Citati dai dati bibliografici e dagli abstract: Politis e Romano, JASA 89(428), 1994, pp. 1303-1313; Cont, Quantitative Finance 1(2), 2001, pp. 223-236. Dati della prova: chiusure giornaliere dell’indice S&P 500 da Yahoo Finance, 03/01/2000-15/10/2026, solo prezzo. Il calcolo è nostro, a scopo didattico, con 1.000 serie per metodo e seme casuale fisso, ed è riproducibile. Le caratteristiche dei bot vengono dalle schede di Amicobot. Questa pagina non contiene link di affiliazione.

Disclaimer

Pagina informativa realizzata con l’aiuto dell’intelligenza artificiale: non è consulenza finanziaria, né una raccomandazione di investimento, né promozione di prodotti o servizi. Il trading di CFD comporta un elevato rischio di perdita del capitale e i risultati passati non sono indicativi di quelli futuri. Dati e prezzi valgono alla data di pubblicazione. Possibili link di affiliazione: AmicoBot può ricevere una commissione, senza costi aggiuntivi per te. Segnalazioni di errori qui.

Facebook
X
Telegram
WhatsApp

Nessuna tab disponibile.

La simulazione Monte Carlo è una delle tecniche di data augmentation, quella che genera dati da un modello o rimescolando quelli veri. Il termine data augmentation viene dal machine learning e indica lo scopo: aumentare gli esempi per l’addestramento. Nel trading le due parole spesso indicano la stessa cosa. La differenza utile è un’altra: se si rimescolano i trade chiusi o si rigenerano i prezzi.

No. Servono ad aggiungere domande al backtest, non a sostituirlo. Il backtest sui dati veri dice come il sistema si è comportato in una storia che è successa. Le serie sintetiche dicono quanto quel risultato dipende dalla fortuna e quanto poteva andare peggio. Il giudizio finale resta su dati veri mai usati durante lo sviluppo, e poi sul conto reale.

Dipende da cosa si misura. Per la mediana bastano poche centinaia di serie. Per i percentili estremi, come il 95° o il 99° della discesa massima, ne servono migliaia, perché ogni serie in più sposta il valore della coda. Nella prova di questa pagina 1.000 serie per metodo danno percentili stabili al punto percentuale. Un controllo semplice è rifare il calcolo con un seme casuale diverso e vedere se i numeri cambiano.

Per il bootstrap a blocchi e il Monte Carlo bastano poche decine di righe di Python con le librerie di calcolo più comuni. Un foglio di calcolo regge il rimescolamento dei trade, molto meno la rigenerazione dei prezzi. Le reti generative come TimeGAN richiedono invece competenze di machine learning e molta potenza di calcolo. Per chi non programma, i simulatori online lavorano quasi sempre sui trade e non sulle serie di prezzo.

Non si può sapere dalla pagina di vendita, perché quasi nessun venditore lo dichiara. La domanda da porre allo sviluppatore è su quali dati è stato addestrato il modello, su quale periodo è stato verificato e se quel periodo è rimasto fuori dall’addestramento. Senza risposta, l’unico elemento verificabile è il track record reale dopo il lancio. In ogni caso il rischio di perdita del capitale resta a carico di chi usa il sistema.

Scrivici su WhatsApp, ti diamo dati, prezzi e funzionamento dei prodotti che recensiamo. I criteri con cui li valutiamo sono pubblici in ogni scheda.

Lascia un commento

Il commento viene pubblicato dopo l'approvazione della redazione. L'email non viene mostrata.

Dimensione massima dei file caricabili: 2 MB. Puoi caricare: immagine, documento. I link a YouTube, Facebook, Twitter e altri servizi inseriti nel testo dei commenti saranno automaticamente incorporati. Rilascia i file qui

Ti potrebbe piacere anche
Gruppo Telegram

Gruppo Telegram

✕
Canale Telegram